 Богдан Коломиец
AI детектор текста: насколько ему можно верить
Коротко о главном
Как работает AI детектор текста, почему он ошибается на живых людях, что об ИИ-контенте говорят Google и Яндекс и что делать автору перед публикацией.
Короткий ответ: детектор не выносит приговор, он выдаёт вероятность. Рекламные «99,8% точности» на витрине сервиса — это одно, результат на вашем конкретном тексте — другое. Ниже цифры независимых исследований, разница между проверкой на ИИ и на уникальность, позиция поисковых систем и четыре шага перед публикацией.
Скажу сразу, откуда я говорю. Я Богдан, веду блог AI SEO Writer — сервиса, который генерирует SEO-статьи и публикует их в CMS. Я заинтересованная сторона, поэтому обхода детекторов здесь не будет: мы его не делаем и не обещаем.
Как работает AI детектор текста
Вставьте текст в поле — алгоритм посчитает две статистики и вернёт процент. Первая: перплексия, насколько предсказуемо каждое следующее слово. Вторая: burstiness, насколько неровно распределена сложность предложений. Живой автор пишет рвано — длинная фраза, короткая, отступление. Языковая модель усредняет.
Дальше классификатор анализирует эти показатели и выдаёт оценку. Никакой базы «текстов искусственного интеллекта», с которой шло бы сравнение, у инструмента нет. Быстрая проверка занимает секунды, но результат — ставка алгоритма, а не запись в реестре. Тот же метод обработки лежит в основе распознавания стиля почти у всех публичных сервисов, включая те, что зовут себя AI Detector.
Чем проверка текста на ИИ отличается от проверки на уникальность
Задачи разные, а путают их постоянно. Антиплагиат ищет совпадения: сравнивает вашу работу с проиндексированной базой и показывает, откуда взяты фрагменты. Уникальность измерима: её можно перепроверить и получить тот же ответ.
Обнаружение машинного авторства устроено иначе: базы сравнения нет, есть статистическая догадка о стиле. Отсюда следствие, ломающее интуицию: материал с уникальностью 100% может получить 90% «сгенерировано нейросетью», а скопированный откуда-то абзац — пройти как человеческий. Один инструмент ищет источник, второй пытается выявить манеру. Результаты анализа текста несопоставимы.
Насколько точна проверка на ИИ: что показали исследования
Самое цитируемое независимое исследование опубликовано в журнале Patterns в 2023 году, авторы — команда из Стэнфорда. Они прогнали 7 детекторов через 91 эссе TOEFL, написанных живыми людьми: студентами, для которых английский не родной. В среднем инструменты пометили как машинные 61,3% этих работ. Один детектор дошёл до 97,8%. Почти пятая часть эссе (19,8%) была ложно помечена всеми семью сразу. На текстах носителей языка ложных срабатываний почти не было.
Причина не в языке. Алгоритм принимает предсказуемый, шаблонный стиль за машинный — а так пишет любой человек, который осторожничает с формулировками.
В июле 2023 года OpenAI отключила собственный AI Text Classifier, назвав причиной низкую точность. По пересказам того объявления, инструмент верно опознавал сгенерированные тексты примерно в четверти случаев. Ошибочно помечал около 9% человеческих. 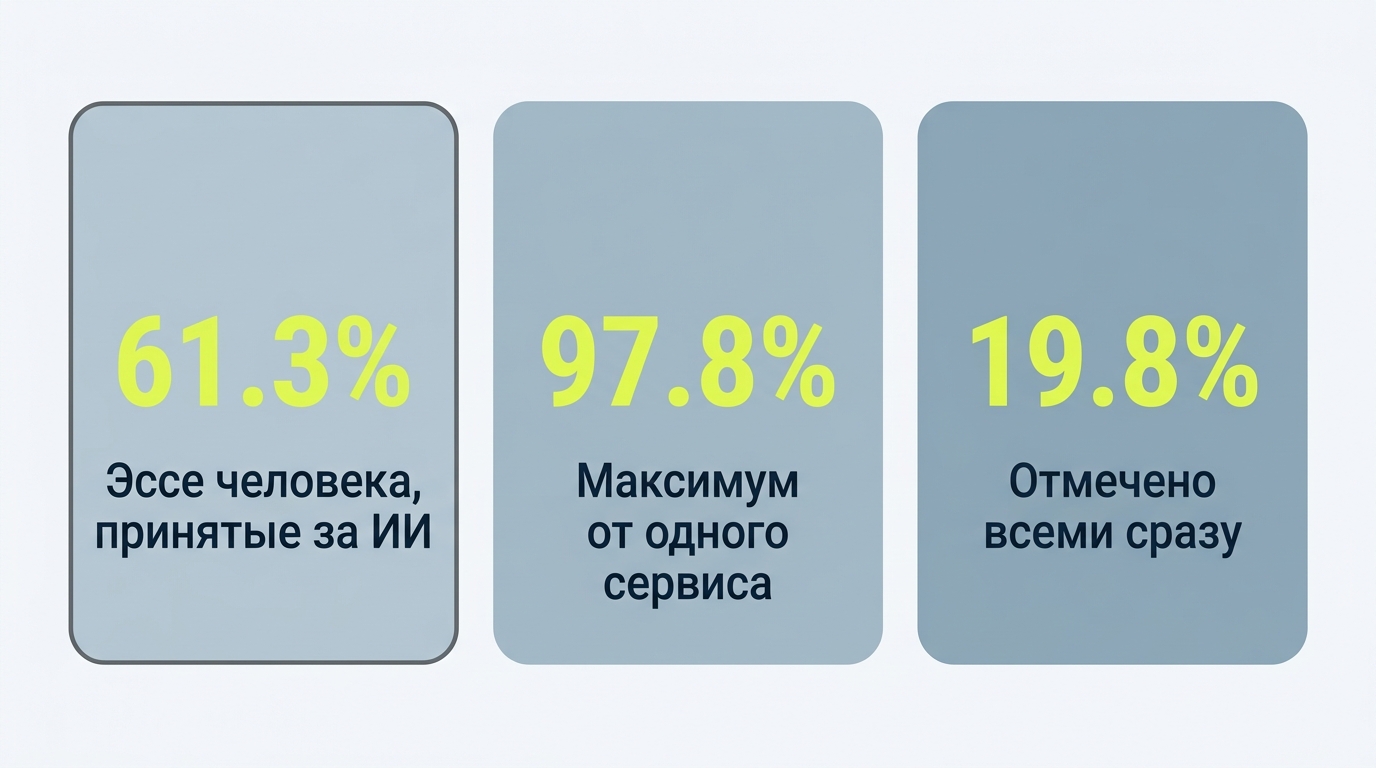
Что известно про русский язык
Данных заметно меньше. В 2025 году ИТМО сообщил об алгоритме, который определяет авторство верно в 94% случаев на корпусе в 5,5 тысячи русскоязычных текстов. Важная деталь: там, где человек написал черновик, а нейросеть его обработала, показатель падал до 80%.
GigaCheck от Сбера заявляет 94,7%, но независимой публикации с методикой и долей ошибок я не нашёл. Открытых замеров ложных срабатываний на русском нет вообще — держите это в голове, когда сервис обещает распознавать любую модель.
Что детектор видит, а чего не видит
| Улавливает | Не улавливает |
|---|---|
| Ровный ритм и одинаковую длину предложений | Правдивость фактов и цифр |
| Шаблонные связки между абзацами | Наличие у автора реального опыта |
| Отсутствие конкретики: чисел, имён, дат | Пользу материала для читателя |
| Усреднённые формулировки без позиции | Авторство после серьёзной правки |
Высокий процент обнаружения чаще означает не «вас поймали», а «здесь пусто». Сигнал полезный, но не про способ создания.
Что об ИИ-текстах говорят Google и Яндекс
У Google позиция опубликована. В документе Search Central от 8 февраля 2023 года сказано прямо: «Google will reward high-quality content however it is produced» — вознаграждается качественный материал независимо от способа создания. На вопрос, нарушает ли ИИ-контент правила, там же дан ответ «No» с оговоркой: при условии, что он написан для людей, а не ради манипуляции ранжированием.
Обновление спам-политик от 5 марта 2024 года заменило прежнюю формулировку про автоматически сгенерированный контент на scaled content abuse. Ключевые слова документа — «no matter how it is created»: под санкции попадает массовое производство неоригинальных страниц ради позиций, а инструмент значения не имеет.
У Яндекса отдельной политики по нейросетевым текстам я не нашёл ни в справке Вебмастера, ни в официальном блоге. Всё, что цитируют в отрасли, — интерпретации агентств. Зато давно есть понятия малополезного контента и SEO-текстов: страниц без оригинальной ценности, сделанных для робота. Логика та же, и она про результат, а не про способ.
Что делать автору перед публикацией
- Проверить факты. Модель уверенно ошибается в цифрах, датах и цитатах — я разбирал, где нейросеть врёт чаще всего.
- Добавить то, чего у модели нет: свои цифры, свой случай, свою позицию. Заодно снимается главная претензия алгоритмов обнаружения — отсутствие конкретики.
- Убрать шаблонные переходы и выровненные абзацы одинаковой длины.
- Проверить текст сервисом последним действием и читать результат как карту пустых мест. Высокий процент указывает на раздел, где нет ни одной вашей мысли, — правьте раздел, а не формулировки.
Отдельный разговор — как писать статьи с ИИ под Яндекс, там требования к фактуре жёстче. Когда нужна проверка текста на ИИ до публикации, берите два-три сервиса сразу: расхождение между ними показательнее любой отдельной цифры.
Как это устроено у нас
Генератор SEO-статей собирает материал из анализа выдачи, пишет его и публикует в CMS вместе с мета-тегами и картинками. Чего он не делает — не выдаёт статью за написанную вручную и не подстраивается под ИИ-детекторы. Редактура человеком остаётся обязательным этапом: фактуру, цифры и личный опыт добавляет автор. Гарантий по позициям мы не даём, а обещать, что материал не определится как машинный, честный инструмент не может.
Частые вопросы
Можно ли доверять результату проверки? Как ориентиру — да, как доказательству — нет. Данные Patterns показывают ошибку на человеческих работах в десятки процентов.
Мой текст пометили как ИИ, хотя я писал сам. Посмотрите, какие абзацы дают высокий процент: обычно это места без конкретики. Добавьте детали и перепроверьте.
Есть ли бесплатный AI Detector? Да, у большинства публичных сервисов достаточно вставить текст в форму без регистрации. Но «наш детектор точен на 99%» в описании такого сервиса — маркетинг, а не измерение. И «наш детектор обучен на русском» тоже требует ссылки на замеры.
Влияет ли процент ИИ на позиции? Напрямую нет: поисковые системы этот показатель не используют. Влияет то, что за ним обычно стоит — пустой текст без пользы.
Вместо гадания на детекторах полезнее смотреть на сам текст: анализ текста покажет однообразные повторы и длину предложений — то, из-за чего текст и читается machine-подобно.
Поделиться
Автоматизируйте SEO-публикации с SEO Writer
ИИ пишет статьи, публикует в CMS, заполняет мета-теги — без вашего участия
Начать бесплатно →Читайте также
Токены нейросети: что это и как считать расход
Токены нейросети: чем токен отличается от слова, почему русский текст дороже английского и как считать расход генерации.
Перелинковка сайта: схемы, анкоры и типичные ошибки
Как устроена перелинковка страниц сайта: зачем она нужна, какие бывают схемы, сколько ссылок ставить в статью, как подобрать анкоры и каких ошибок избежать.
Поведенческие факторы: что это и как их улучшить
Что относится к поведенческим факторам, как Яндекс их считает, что реально можно улучшить текстом и чем заканчивается накрутка.
Интеграции SEO Writer


