 Богдан Коломиец
EEAT-факторы: что это и как показать экспертность
Коротко о главном
Разбираю EEAT-факторы: опыт, экспертиза, авторитетность, доверие. Что из этого проверяет поисковик, при чём тут YMYL и как показать экспертность в статье с ИИ.
SLUG: eeat-faktory
Коротко: это не переключатель в алгоритме, а рамка, по которой Google описывает качественный контент. Четыре слова — опыт, экспертиза, авторитетность, доверие. Google прямо пишет, что сам по себе E-E-A-T не является фактором ранжирования, но системы поиска используют набор сигналов, которые помогают находить материалы с хорошим E-E-A-T, и в чувствительных темах вес этих сигналов выше.
«Меня чаще всего спрашивают одно: если текст собрала нейросеть, откуда в нём экспертность. Отвечаю честно — из человека. Модель даёт каркас, структуру и черновик за минуты. Опыт, свои цифры и проверенные факты в этот каркас приносит автор. Ни одна генерация сама по себе доверия поисковика не создаёт», — Богдан, автор блога AI SEO Writer.
Дальше разбираемся, что из четырёх букв поиск способен проверить машинно, что не измеряется в принципе и как выглядит материал, который писали с помощью ИИ и который при этом не читается как пустой.
Что такое EEAT-факторы простыми словами
Аббревиатура собрана из четырёх английских слов и описывает, по каким признакам оценивают качество страницы. Термин пришёл не из алгоритма, а из руководства для асессоров — документа, по которому живые люди оценивают выдачу Google. К привычным требованиям к SEO-тексту это добавляет слой, который проверяется не вхождениями ключей, а репутацией автора и сайта.
Руководство лежит в открытом доступе: PDF на домене guidelines.raterhub.com, около девяти мегабайт текста с примерами и разбором конкретных страниц. На момент подготовки этого материала файл датирован 11 сентября 2025 года. Это не секретная инструкция и не утечка: Google публикует его специально, чтобы владельцы сайтов понимали логику оценки.
Историю полезно держать в голове. Три буквы, E-A-T, прожили в руководстве около десяти лет до появления четвёртой. Опыт добавили позже, когда выдачу заполнили пересказы пересказов. Для владельца сайта отсюда следует одна вещь: требования не переписывают каждый квартал, они уточняются. Работа, сделанная под прошлую формулировку, не сгорает.
Расшифровка E-E-A-T и откуда взялась вторая «E»
Четыре компонента раскрываются так:
| Буква | Термин | Что означает |
|---|---|---|
| E | Experience | Опыт — автор сам сталкивался с тем, о чём пишет |
| E | Expertise | Экспертиза — у автора есть знания и квалификация в теме |
| A | Authoritativeness | Авторитетность — автора и сайт признают источником в нише |
| T | Trustworthiness | Достоверность — материалу и сайту можно верить |
До декабря 2022 года букв было три: E-A-T, без опыта. Вторую «E» Google добавил 15 декабря 2022 года и объявил об этом в блоге Search Central формулировкой «E-E-A-T — or "Double-E-A-T", if you prefer, is now part of the updated search rater guidelines we've just released».
Смысл добавления понятен на бытовом примере. Один автор прочитал десять обзоров робота-пылесоса и пересказал их. Второй месяц гонял этот пылесос по квартире с котом и знает, что щётка забивается шерстью на третий день. Экспертиза может быть выше у первого. Опыт есть только у второго — и читателю нужен именно он.
Почему доверие важнее остальных трёх букв
Google выделяет достоверность отдельно: «Trust is the most important member of the E-E-A-T family because untrustworthy pages have low E-E-A-T no matter how Experienced, Expert, or Authoritative they may seem». В схеме из документации доверие стоит в центре, а опыт, экспертиза и авторитетность работают на него.
Легче понять на встречном примере. Медицинская статья написана доктором наук — опыт и экспертиза максимальные. Но сайт без контактов, без юридического лица, с тремя всплывающими баннерами и кнопкой «купить курс». Совокупная оценка такой страницы будет низкой, потому что доверия к ней нет, а без доверия остальные три буквы не спасают.
EEAT — не фактор ранжирования. Тогда зачем он нужен
В документации Google сказано прямо: «E-E-A-T itself isn't a specific ranking factor». Внутри поиска нет числа, которое считается для страницы и подмешивается в позицию. Есть множество сигналов, которые помогают системам находить материалы, соответствующие этому описанию, и для чувствительных тем этим сигналам придаётся больший вес.
Важно понимать разницу: сигналы влияют на оценку качества страницы, а качество уже влияет на позиции в выдаче. Прямой линии «прошёл чек-лист — вырос на десять пунктов» не существует.
Отсюда практический вывод: искать «формулу» бесполезно. Полезнее относиться к четырём буквам как к чек-листу редактора, который совпадает с тем, что поиск считает хорошим.
Что делают асессоры и при чём тут алгоритмы
Асессоры оценивают качество выдачи по руководству, но их оценки не двигают позиции конкретного сайта. Оценка — обратная связь: по ней проверяют, стало ли выдаче лучше после изменения алгоритма.
История редакций документа показывает, куда движется требование к качеству:
| Дата | Что изменилось |
|---|---|
| 15.12.2022 | добавлена Experience, E-A-T стал E-E-A-T |
| 16.11.2023 | упрощены определения шкалы Needs Met, добавлены современные форматы |
| 05.03.2024 | разделы про низкое качество выровнены со спам-политиками |
| 23.01.2025 | добавлены определения и правила оценки контента, созданного ИИ |
| 11.09.2025 | обновлены определения YMYL, добавлены примеры под AI Overviews |
Январская редакция 2025 года интересна отдельно. В ней появилась прямая формулировка: если основной контент страницы скопирован, перефразирован, встроен с чужого ресурса или сгенерирован автоматически и не добавляет ценности, страница получает низшую оценку — даже когда источник указан.
Учитывает ли похожие сигналы Яндекс
Самого термина в документации Яндекса нет — это словарь Google. Но критерии описаны почти теми же словами.
В справке Вебмастера про метрику качества Проксима перечислено, что учитывается при оценке страницы: релевантность запросу, вероятность решения задачи пользователя, качество, полезность и оригинальность контента, баланс полезного и навязчивого, удобство потребления и отдельным пунктом — дополнительные сигналы о качестве контента и авторитетности автора в сложных тематиках, среди которых прямо названы медицина, юридические и финансовые услуги.
Также в блоге Вебмастера об обновлении алгоритма определения качественного контента сказано ещё конкретнее: алгоритм сильнее учитывает показатели экспертности и доверия пользователей к материалам и лучше выявляет спам, в том числе автоматически созданные тексты без добавленной ценности и без человеческой проверки.
Разные названия, одна логика. Оптимизировать сайт отдельно под Google и отдельно под Яндекс здесь не нужно: SEO-работа одна и та же.
YMYL: темы, где цена ошибки максимальная
YMYL расшифровывается как Your Money or Your Life. Google формулирует так: «We call these "Your Money or Your Life" topics, or YMYL for short». Это темы, ошибка в которых может существенно повлиять на здоровье, финансовую стабильность, безопасность человека или благополучие общества.
Ключевое слово — вред. Раньше руководство давало жёсткий список категорий, теперь просит асессоров думать через риск: насколько плохо будет читателю, если совет окажется неверным. 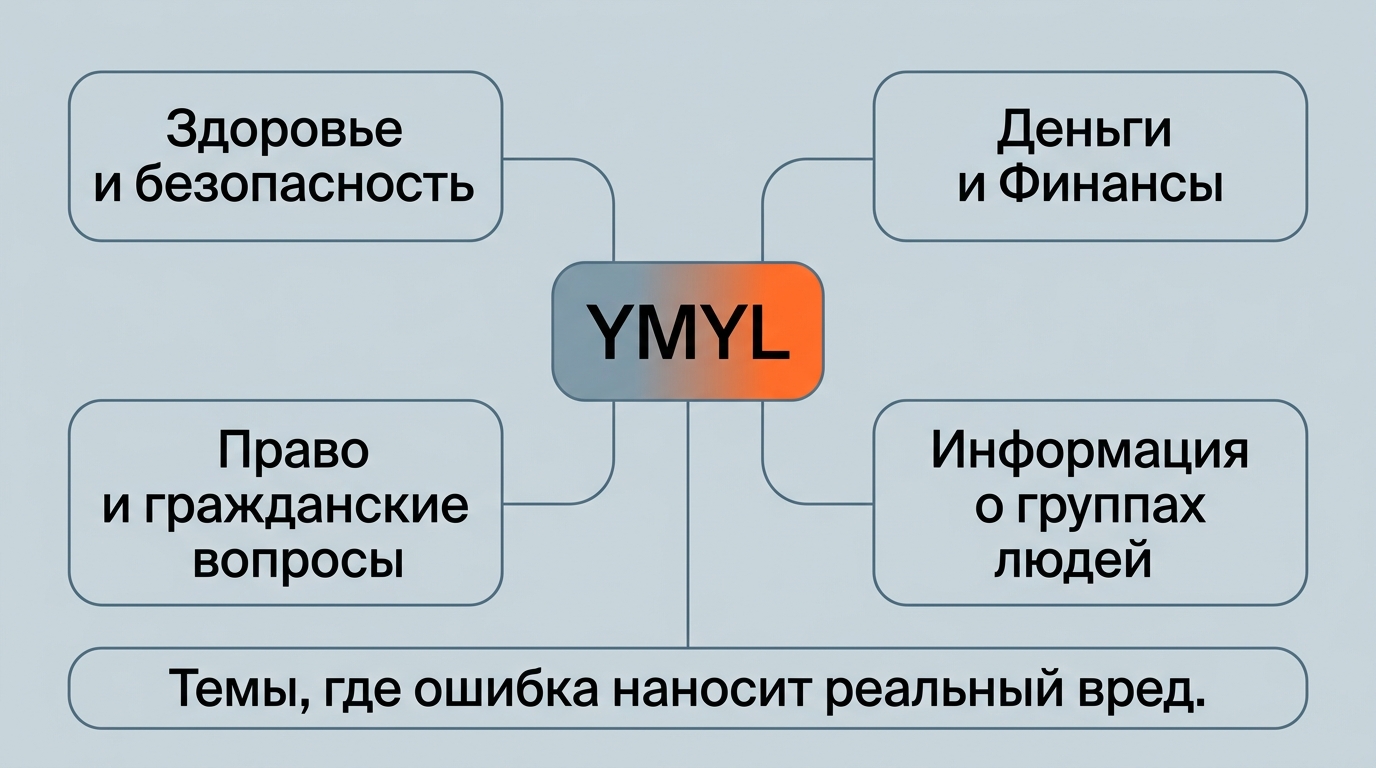
Какие темы относятся к YMYL
Условно они распадаются на четыре крупных блока:
- Здоровье и безопасность. Симптомы, лекарства, дозировки, диагнозы, поведение при аварии или пожаре.
- Финансовая стабильность. Инвестиции, кредиты, налоги, пенсия, страхование, крупные покупки, любые страницы с оплатой.
- Право и гражданские вопросы. Суды, наследство, опека, выборы, государственные услуги.
- Информация о группах людей. Утверждения о людях, сгруппированных по возрасту, национальности, религии, полу, состоянию здоровья и другим подобным признакам.
Не всякий текст в этих нишах попадает под YMYL. Рецепт борща — не YMYL, а материал «сколько парацетамола можно ребёнку» относится к нему в полной мере, хотя обе статьи формально про еду и быт. Смотреть надо на цену ошибки для читателя, а не на рубрику сайта.
Определения YMYL в руководстве уточняли в сентябрьской редакции 2025 года — значит, тема для поиска остаётся живой.
Что меняется в работе над YMYL-страницей
Планка поднимается по всем четырём буквам сразу:
- У материала есть автор с профильной квалификацией либо рецензент, и квалификацию видно на странице.
- Каждое числовое утверждение опирается на первоисточник, а не на пересказ чужой статьи. Наличие ссылки на норму или исследование здесь не пожелание, а условие.
- У страницы стоят дата публикации и дата последнего обновления.
- На сайте есть юридическое лицо и контакты, а для медицины и финансов — лицензии и обязательные предупреждения.
- Вредных советов нет, границы применимости названы явно.
Отдельная ловушка — коммерческие страницы. Карточка товара с оплатой формально попадает в YMYL, потому что читатель расстаётся с деньгами. Условия возврата, реквизиты и живые отзывы значат для неё больше, чем очередной абзац с ключами.
Для российских сайтов к этому добавляются требования законодательства о рекламе медицинских и финансовых услуг. Это отдельная тема, но игнорировать её нельзя: страница может быть безупречной по перечисленным критериям и при этом нарушать закон.
Что из EEAT поисковик проверяет, а что нет
Здесь проходит граница, из-за которой ломается половина обсуждений. Часть сигналов машина считывает буквально. Часть не измеряется вообще, и поиск опирается на косвенные признаки. 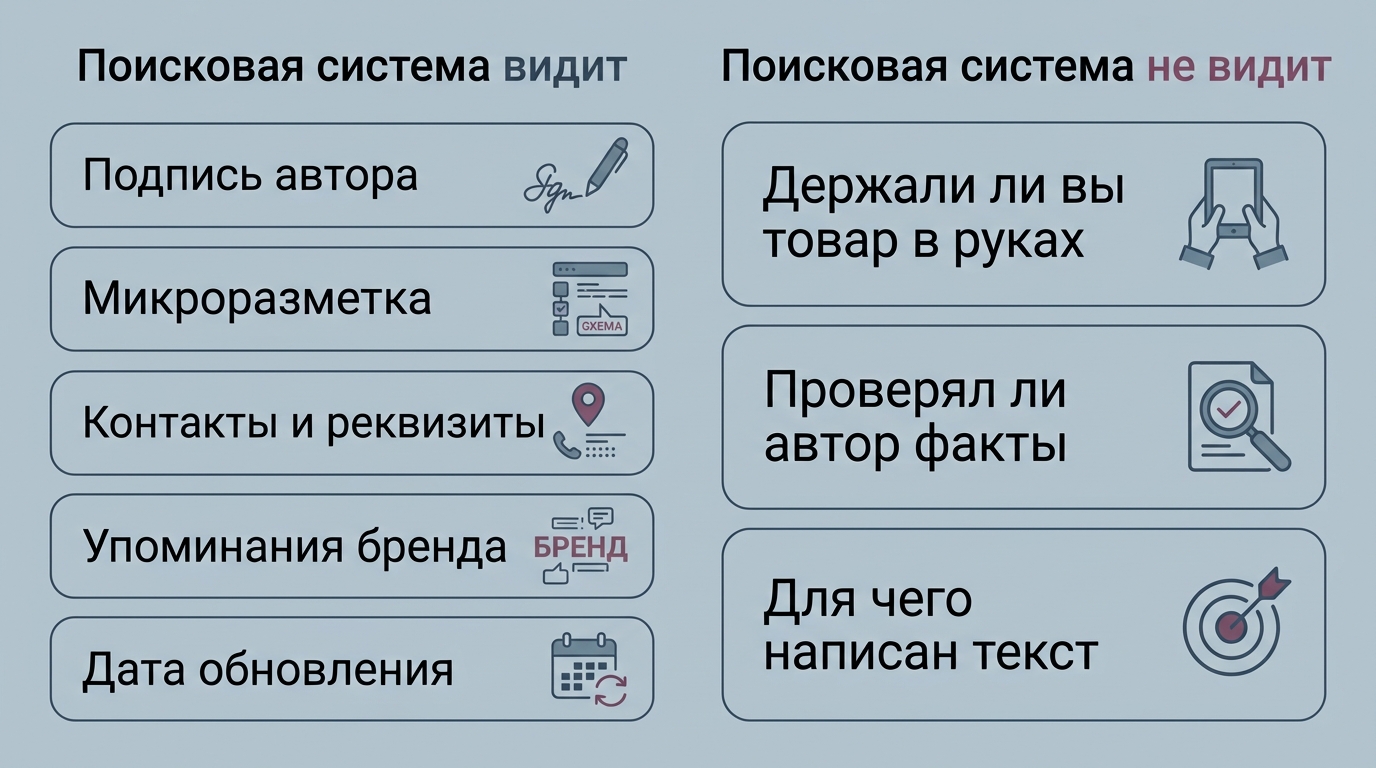
Сигналы, которые считываются машинно
| Что проверяется | Как это видно поиску |
|---|---|
| Авторство | подпись под материалом, ссылка на страницу автора, микроразметка Person |
| Прозрачность бизнеса | страницы «О компании» и «Контакты», реквизиты, юридическое лицо |
| Техническое доверие | HTTPS, политика конфиденциальности, работающие формы |
| Репутация | упоминания бренда и имени автора на сторонних площадках, ссылки на домен |
| Актуальность | дата публикации и дата обновления материала |
| Структура данных | разметка Article, Organization, Person и её соответствие содержанию |
| Соответствие интенту | отвечает ли страница на запрос, ради которого её открыли |
| Достоверность фактов | расхождение утверждений с тем, что пишут авторитетные источники по теме |
Всё это — наличие или отсутствие конкретных элементов. Такие вещи закрываются один раз и работают дальше на весь сайт.
Порядок работы я советую такой. Сначала техническая часть и прозрачность: контакты, реквизиты, политика, разметка. Это делается за день и относится сразу ко всем страницам. Потом авторы: подпись, отдельная страница, ссылка из подписи на неё. Репутацию оставьте на последнее место — упоминания и отзывы копятся месяцами, разогнать их одним действием не выйдет. Также сразу проставьте даты обновления: это дешевле сделать один раз, чем возвращаться к сотне страниц потом.
Опыт и намерение: то, что напрямую не измеряется
Ни один алгоритм не знает, держал ли автор товар в руках, ездил ли он на этой машине и проверял ли свои цифры перед публикацией. Поиск оценивает это косвенно — по деталям, которых нет в других текстах выдачи.
Работают вещи, которые невозможно списать: собственные фотографии вместо стока, конкретное число вместо «много», описание того, что пошло не так, названные точно срок и стоимость. Эти признаки и отличают статью с опытом от компиляции десяти чужих статей.
Отсюда правило, которое я считаю главным во всей теме: опыт нельзя задекларировать, его можно только показать деталью. Фраза «мы работаем с 2015 года и обладаем большим опытом» не сообщает читателю и поиску ничего. Абзац про то, как на третьем проекте вылезла проблема и сколько её чинили, сообщает всё.
Как показать опыт и экспертизу в тексте статьи
Дальше прикладная часть. Всё, что перечислено ниже, применимо к любому материалу независимо от того, писал его человек с нуля или собирал с помощью нейросети.
Опыт: детали, которых нет в выдаче
Разберу на своём примере. Когда я в первый раз прогнал целую пачку статей через приёмку по вхождениям ключей, четыре текста из пяти ушли в брак: переспам вышел на 17–26 процентов при пороге в 10. Я разобрал причину — почти половина блоков, 37 из 79, начиналась с пересказа собственного заголовка. Под заголовком «Технический аудит сайта: чек-лист» первое предложение начиналось со слов «Технический аудит сайта — это…». Правило «первое предложение отвечает, а не повторяет» сняло проблему на следующей пачке и заодно попало в мой рабочий свод по структуре статьи.
Это и есть опыт в чистом виде: мини-кейс, который нельзя пересказать из чужой статьи, потому что чисел 37 из 79 больше нигде нет.
Что можно вытащить из своей практики почти всегда:
- Что вы пробовали и что не сработало, с причиной.
- Сколько времени и денег заняло на деле, а не по прайсу.
- Скриншоты из своих интерфейсов и отчётов вместо картинок из фотобанка.
- Реальные показатели проекта, а не округлённые оценки «примерно вдвое».
- Ограничение, о котором молчат конкуренты.
Экспертиза: цифры, методика и границы применимости
Экспертизу видно по трём вещам. Первая — конкретика вместо оценок: не «трафик заметно вырос», а «за квартал показы выросли с 12 до 41 тысячи». Вторая — методика: на какой выборке получен результат, за какой период, чем измеряли. Третья, которую пропускают почти все, — границы применимости: где совет не работает.
Важна и актуальность данных: цифра трёхлетней давности в быстро меняющейся теме работает против автора.
Абзац «этот способ бесполезен, если у сайта меньше сотни страниц» добавляет доверия больше, чем ещё пять советов. Читатель понимает, что автор различает ситуации, а не пересказывает общую схему.
Ссылки на первоисточники указывайте читаемым текстом — с названием документа и датой, а не безликим «по данным исследования». Также помогает открыто названная методика: читателю должно быть понятно, откуда взялось число. Если утверждение взято из руководства для асессоров, так и напишите.
Авторство: подпись, страница автора, микроразметка
Google формулирует рекомендацию так: «We strongly encourage adding accurate authorship information, such as bylines to content where readers might expect it». В блоке самопроверки из документации есть прямые вопросы: очевидно ли посетителю, кто написал материал, и ведёт ли подпись к сведениям об авторе и темах, о которых он пишет. Само наличие подписи материал экспертным ещё не делает — за ней должна стоять проверяемая квалификация.
Минимальный рабочий набор выглядит так:
- Подпись под заголовком с именем и ролью автора.
- Страница автора: биография, квалификация, темы, ссылки на профили и публикации.
- Микроразметка Article, где author задан типом Person, с полями author.name и author.url.
- Дата публикации и дата обновления, соответствующие действительности.
Формального требования «нет автора — нет позиций» в документации Google нет: авторство описано как настоятельная рекомендация, а не условие ранжирования. Но для YMYL-тем это фактически обязательный минимум, и Яндекс с его акцентом на авторитетность автора в сложных тематиках ведёт себя здесь так же.
Экспертность в статье, написанной с помощью ИИ
Возражение против ИИ-контента звучит одинаково: нейросеть не имеет опыта, значит, сгенерированный текст обречён на низкую оценку. Это не так — но и обратное, «сгенерируй и получишь экспертность», тоже неправда. Разбор того, что нейросеть умеет при написании статей и где ошибается, имеет смысл держать рядом: половина претензий к ИИ-контенту адресована не модели, а тому, кто её запускал.
Что Google официально говорит про AI-контент
Позиция опубликована 8 февраля 2023 года отдельной страницей в блоге Search Central и с тех пор по сути не менялась. Ключевые формулировки:
- «Appropriate use of AI or automation is not against our guidelines» — уместное использование автоматизации не нарушает правила.
- «Our ranking systems aim to reward original, high-quality content that demonstrates qualities of what we call E-E-A-T» — награждается качество, а не способ производства.
- «Using automation — including AI — to generate content with the primary purpose of manipulating ranking in search results is a violation of our spam policies» — нарушением считается намерение манипулировать выдачей.
Также в спам-политиках описан scaled content abuse: массовое создание страниц ради позиций, а не ради пользы. Прямо названный пример — использование генеративных инструментов для производства множества страниц без добавленной ценности для пользователей.
Яндекс говорит о том же в блоге Вебмастера, называя автоматически созданные материалы без добавленной ценности и без человеческой проверки признаком некачественного контента.
Итог: под ударом не генерация, а конвейер пустых страниц.
Что делает модель, а что добавляет человек
Разделение ролей выглядит так:
| Делает модель | Добавляет человек |
|---|---|
| Структура по анализу конкурентов из ТОП выдачи | Решение, какой из выводов верен для этой ниши |
| Черновик на 1 200–2 000 слов за считаные минуты | Свои цифры, скриншоты, кейсы из практики |
| Подбор LSI, мета-теги, варианты заголовков | Проверка фактов, дат и формулировок первоисточников |
| Перелинковка по индексу опубликованного | Авторская позиция и границы применимости советов |
| Публикация в CMS и анонсы в соцсетях | Подпись, квалификация, ответственность за текст |
Поэтому в собственном сервисе я формулирую задачу без обещаний: генерация закрывает каркас и рутину, а сигналы EEAT добавляет автор. Черновик за пять минут экономит те самые два-три дня, которые обычно уходят на цепочку «копирайтер — SEO-специалист — редактор». Освободившееся время имеет смысл потратить не на следующую статью, а на то, чтобы в текущую вписать свой опыт.
Порядок на практике такой. Модель собирает структуру и черновик по анализу выдачи. Автор вычитывает фактуру — даты, цифры, цитаты, то есть места, где генерация ошибается чаще всего. Затем вписывает своё: случай из работы, скриншот, число, которого нет ни у кого в ТОП-10. В конце ставит подпись и берёт ответственность за написанное. Понятно, что первый шаг самый быстрый, а два следующих забирают время автора. Пропустите второй и третий шаг — получите ровно ту страницу, которую руководство для асессоров описывает как контент без добавленной ценности. Как выглядит такой каркас до правок автора, видно на примерах сгенерированных статей.
Надо ли помечать, что текст готовила нейросеть
Google отвечает мягко. В блоке самопроверки есть вопросы «очевидно ли использование автоматизации посетителям» и «объясняете ли вы, как именно автоматизация применялась». Дальше следует формулировка: раскрытие полезно для контента, о котором читатель мог бы спросить «как это сделано», и добавлять его лучше там, где этого разумно ожидать.
Обязанности вешать плашку на каждую страницу нет. Мой практический ответ такой: важнее не лейбл, а то, что за материалом стоит человек, готовый отвечать за написанное — подписью, квалификацией и контактами.
Попытка вычислить происхождение текста машинной проверкой к этому вопросу отношения не имеет. Я отдельно разбирал, насколько можно верить AI-детектору текста: инструменты ошибаются в обе стороны, а ни один поисковик не заявлял, что использует их оценки при ранжировании.
Чек-лист проверки страницы по EEAT-факторам
Пройдите по пунктам — каждый закрывается за один заход.
Доверие
- На сайте есть страница «Контакты» с телефоном, почтой и реквизитами.
- Работает HTTPS, опубликована политика обработки персональных данных.
- Реклама и всплывающие блоки не мешают читать основной контент.
Авторство
- У материала есть подпись с именем и ролью автора.
- Подпись ведёт на страницу автора с биографией и списком тем.
- Настроена микроразметка Article с author типом Person.
- Указаны дата публикации и дата последнего обновления.
Контент
- Первый абзац отвечает на вопрос заголовка, а не пересказывает его.
- В тексте есть минимум одна деталь, которой нет у конкурентов из выдачи: своя цифра, свой скриншот, свой случай.
- Числовые утверждения снабжены читаемой ссылкой на первоисточник.
- Названы границы применимости: где совет не работает.
- Материал соответствует интенту запроса, по которому его открывают.
- Актуальность проверена: даты, цены и цифры не устарели, разметка соответствует тому, что написано на странице.
Репутация
- Имя автора или бренд упоминаются на сторонних площадках.
- Отзывы собраны, и на них есть ответы.
Отдельно для YMYL
- Автор или рецензент имеет профильную квалификацию, и это видно на странице.
- Утверждения сверены с первоисточниками, а не с чужими статьями.
- Опубликованы лицензии и обязательные предупреждения.
Вопросы, которые задают чаще всего
Учитывает ли Яндекс EEAT? Термин Яндекс не использует, но метрика Проксима прямо учитывает качество и оригинальность контента, а в сложных тематиках — авторитетность автора. Логика совпадает, различаются только слова.
Можно ли улучшить оценку новому сайту? Часть сигналов доступна сразу: контакты, реквизиты, страницы авторов, микроразметка, честные тексты. Репутация и упоминания копятся дольше, и быстрого способа здесь нет.
Как быстро виден эффект? Прогнозов по срокам не существует ни в одном официальном документе. Изменения обычно проявляются на очередном обновлении алгоритма, а не на следующий день после правок.
Нужен ли рецензент для статей вне YMYL? Не обязателен. Достаточно указать автора и показать его опыт — рецензент решает задачу там, где ошибка стоит здоровья или денег.
Помогает ли микроразметка сама по себе? Оценку она не повышает. Разметка делает машиночитаемыми уже существующие сведения об авторе и организации — если сведений нет, размечать нечего.
Считается ли рерайт чужой статьи опытом? Нет. В январской редакции руководства 2025 года перефразированный контент без добавленной ценности прямо отнесён к низшему уровню качества, даже когда указан источник.
Что важнее — ссылки или контент? Внешние ссылки и упоминания работают на авторитетность, но при недостоверном контенте не спасают: доверие Google называет главным элементом, без которого остальные три не работают.
Поделиться
Автоматизируйте SEO-публикации с SEO Writer
ИИ пишет статьи, публикует в CMS, заполняет мета-теги — без вашего участия
Начать бесплатно →Читайте также
Токены нейросети: что это и как считать расход
Токены нейросети: чем токен отличается от слова, почему русский текст дороже английского и как считать расход генерации.
Перелинковка сайта: схемы, анкоры и типичные ошибки
Как устроена перелинковка страниц сайта: зачем она нужна, какие бывают схемы, сколько ссылок ставить в статью, как подобрать анкоры и каких ошибок избежать.
Поведенческие факторы: что это и как их улучшить
Что относится к поведенческим факторам, как Яндекс их считает, что реально можно улучшить текстом и чем заканчивается накрутка.
Интеграции SEO Writer


