 Богдан Коломиец
llms.txt: что это за файл, пример и нужен ли он сайту
Коротко о главном
Что такое llms.txt, как он устроен по стандарту llmstxt.org, чем отличается от robots.txt и sitemap.xml, кто его читает и нужен ли он вашему сайту.
SLUG: llms-txt
Коротко: llms.txt — текстовый файл в разметке Markdown, который лежит в корне сайта рядом с robots.txt и в двух десятках строк объясняет языковым моделям, что это за сайт и какие страницы на нём главные. Составить его можно за 15 минут. Позиции в Яндексе и Google он не поднимет: Google прямо пишет, что его поиск такие файлы не использует, а Яндекс официально о нём не высказывался.
Меня зовут Богдан, я веду блог сервиса SEO Writer. В октябре 2026 года я выложил собственный llms.txt на ai-seowriter.ru, а перед этим перечитал первоисточник, официальные заявления поисковиков и с десяток российских гайдов. Мой вывод: «Штука полезная, но не для тех, кому её обычно продают. Это не новый robots.txt и не пропуск в ответы нейросетей, а аккуратное оглавление для ИИ-агентов, которым пользователь сам дал адрес вашего сайта».
Дальше разберу, как устроен llms.txt, чем он отличается от карты сайта и robots.txt, зачем придумали llms-full.txt, кто на деле читает этот файл и как составить свой. В конце — честные критерии, нужен ли он именно вам.
Что такое llms.txt простыми словами
Обычная веб-страница сделана для человека: меню, баннеры, всплывающие окна, скрипты. Модели всё это мешает. Чтобы достать из HTML смысл, его приходится чистить, а каждый лишний токен стоит времени и денег. Чем больше мусора вокруг полезных данных, тем дороже ответ и тем выше шанс, что модель пропустит главное среди этих данных. Автор стандарта формулирует проблему так: контекстное окно моделей всё ещё слишком мало для сайта целиком, поэтому агентам нужна краткая информация экспертного уровня, собранная в одном месте.
llms.txt и есть такое место. По адресу /llms.txt лежат название сайта, описание в одну-две фразы и ссылки на ключевые страницы с короткими пояснениями. Агент читает его, понимает, где что лежит, и только потом открывает нужную страницу.
Деталь, которую часто упускают: файл рассчитан на работу «по запросу», а не на обучение моделей. На llmstxt.org прямо сказано, что от него ждали пользы при ответе на вопрос пользователя, когда агенту срочно нужны данные по теме, и на практике так и вышло. Поисковый робот, который обходит интернет, и агент, которому человек только что прислал адрес вашего сайта, — разные читатели. llms.txt пишется для второго.
Кто придумал стандарт и что изменилось во второй версии
Идею опубликовал Джереми Говард, сооснователь Answer.AI, в сентябре 2024 года. Это не стандарт W3C и не требование поисковых систем, а открытое предложение: исходники лежат на GitHub в репозитории AnswerDotAI/llms-txt, там же идёт обсуждение: правки к llms-txt предлагают через issue и pull request.
В августе 2026 года вышла вторая версия. По словам автора, за два года стандарт llms.txt подхватили тысячи сайтов, платформы документации генерируют его автоматически, а Chrome Lighthouse проверяет его наличие в аудитах агентного браузинга (раздел Changes на llmstxt.org). Что поменялось в v2:
- Подкаталоги. Положить файл можно не только в корень, но и, например, в
/docs/llms.txt. Он описывает страницы под своим путём, а если файлов несколько, действует наиболее конкретный. - Markdown-версии страниц. Разрешены оба варианта адреса:
page.html.mdиpage.md. - Обнаружение. Появились стандартные связи:
rel="alternate" type="text/markdown"ведёт на markdown-версию страницы,rel="describedby"— на llms.txt, который её описывает. Их отдают тегом<link>или HTTP-заголовкомLink. - Раздел Optional. Раньше инструмент
llms_txt2ctxвыбрасывал его при сборке контекста. В v2 инструмент убрали, и Optional остался договорённостью для второстепенных материалов.
Как устроен llms.txt: синтаксис по спецификации
Разметка — Markdown, а не XML или JSON. Логика автора: эти файлы в первую очередь читают языковые модели, а Markdown они понимают лучше всего. При этом порядок блоков жёсткий, так что разобрать файл можно и обычной программой, парсером или регулярным выражением.
Порядок блоков по спецификации (в ней же есть короткая инструкция с примером):
- Необязательная метка порядка байтов (BOM).
- Заголовок первого уровня с названием проекта или сайта. Это единственный обязательный элемент.
- Цитата (строка с
>) с кратким описанием: то, без чего остальное не понять. - Ноль или больше абзацев и списков без заголовков — подробности о проекте и о том, как читать ссылки ниже.
- Ноль или больше разделов с заголовком H2. В каждом — список ссылок в формате Markdown: название в квадратных скобках, сразу за ним адрес в круглых. После ссылки можно поставить двоеточие и пояснение.
Заголовки третьего уровня и ниже не предусмотрены. Адреса — полные URL с протоколом. Кодировка — UTF-8, иначе кириллица превратится в кракозябры.
Шаблон файла
Минимальный рабочий вариант, который можно скопировать и заполнить:
# Название сайта

> Одно-два предложения: кто вы, что делаете, для кого. Главные факты, без рекламы.

Дополнительные сведения: регион работы, условия, что важно знать перед чтением перечней.

## Услуги

- [Название услуги](https://example.ru/uslugi/nazvanie): что входит и для кого
- [Цены](https://example.ru/ceny): актуальный прайс

## Документация

- [Как начать](https://example.ru/docs/start): первые шаги
- [Частые вопросы](https://example.ru/faq): ответы на типовые вопросы

## Optional

- [Блог](https://example.ru/blog): статьи, которые можно пропустить при коротком контексте
Названия разделов выбираете вы: «Продукт», «Каталог», «Services», «Docs» — как удобно. Стандарт llms.txt требует структуру, а не конкретные слова, и это прямо следует из спецификации.
Пример: содержимое файла llms.txt на ai-seowriter.ru
Наш вариант опубликован по адресу ai-seowriter.ru/llms.txt. Вот его начало и концовка, середина сокращена:
# SEO Writer

> SEO Writer (ai-seowriter.ru) — российский сервис, который пишет SEO-статьи под ключевые запросы и сам публикует их на сайт: в WordPress, 1С-Битрикс, InSales, Joomla или на любой другой сайт через вебхук. Работает из России без VPN, оплата в рублях, есть бесплатный тариф.

...

## Продукт

- [Главная](https://ai-seowriter.ru/): что делает сервис и как начать
- [Генератор SEO-статей](https://ai-seowriter.ru/generator-seo-statej): как пишется стандартная статья
- [Лонгриды](https://ai-seowriter.ru/longrid): режим длинных статей с анализом конкурентов

## Подключение сайта

- [Все интеграции](https://ai-seowriter.ru/integracii): список платформ и способов подключения
- [WordPress](https://ai-seowriter.ru/wordpress): подключение по REST API или плагином
- [1С-Битрикс](https://ai-seowriter.ru/bitrix): публикация через PHP-коннектор

...

## Optional

- [Блог](https://ai-seowriter.ru/blog): все статьи
- [SEO-текст: что это и как его писать](https://ai-seowriter.ru/blog/seo-tekst)
Всего разделов H2 шесть: «Продукт», «Подключение сайта», «База знаний», «Сравнения», «Бесплатные инструменты» и «Optional». Перед ними, после цитаты, идёт обычный текст: как устроена работа, ключевые факты, тарифы с пометкой «на октябрь 2026», чего мы не обещаем, и контакты, включая Telegram-канал. Этот блок я писал под вопросы, которые чаще всего задают: сколько стоит, работает ли из России, в какие системы публикует, откуда берутся видео (там прямо сказано, что для русских статей их подбирают с RuTube и VK Видео). В Optional ушли статьи блога и юридические документы: без них агент поймёт продукт, а при длинном контексте может их прочитать. 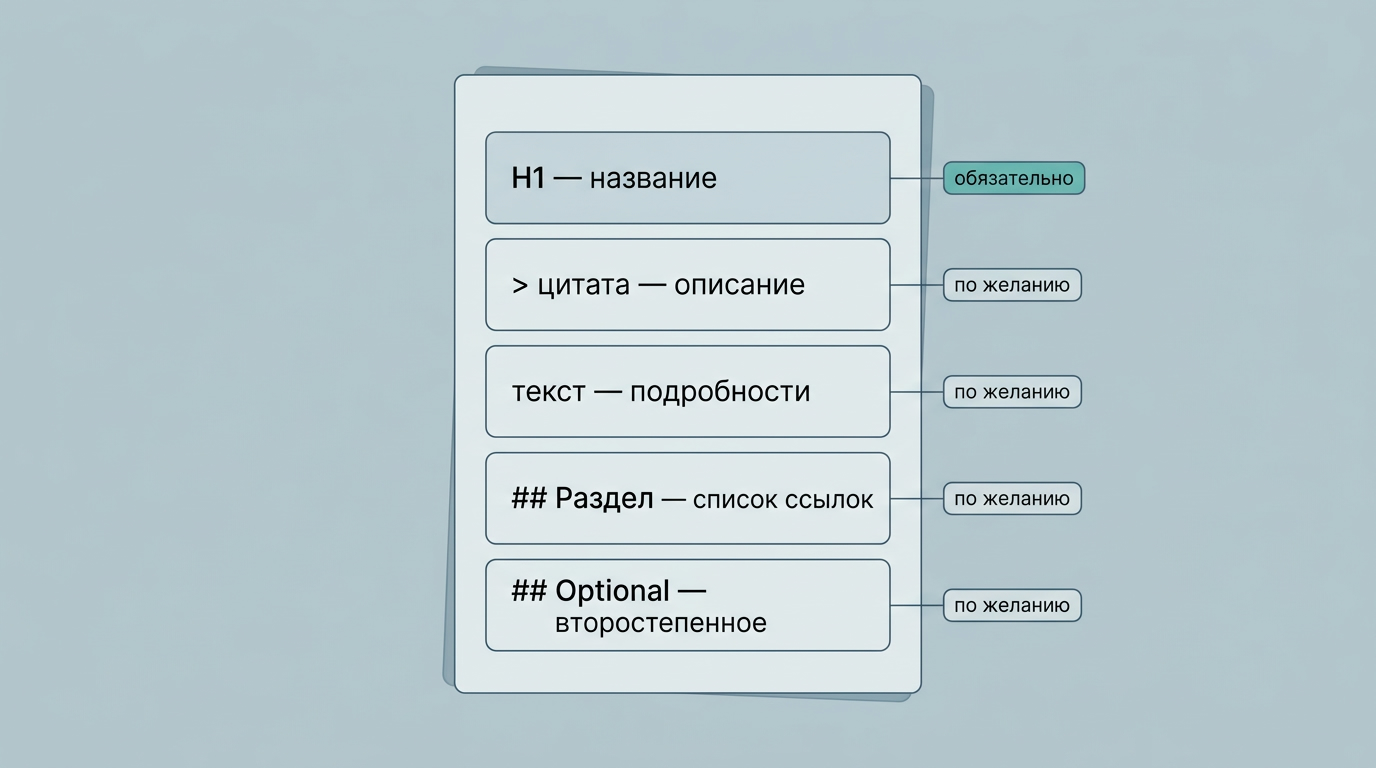
Чем llms.txt отличается от robots.txt и sitemap.xml
Все три лежат в корне сайта и называются предсказуемо, поэтому их постоянно путают. На llmstxt.org прямо сказано: новый файл задуман как дополнение к существующим стандартам, а не замена.
| robots.txt | Карта сайта | llms.txt | |
|---|---|---|---|
| Кому адресован | поисковым и другим роботам | поисковым системам | языковым моделям и ИИ-агентам |
| Что делает | разрешает или запрещает обход | перечисляет все индексируемые страницы | даёт короткое оглавление с пояснениями |
| Формат | директивы | XML | Markdown |
| Объём | десятки строк | до десятков тысяч URL | обычно десятки адресов |
| Поддержка поиском | у всех поисковиков | у всех поисковиков | поисковиками не заявлена |
Главное отличие от robots.txt: llms.txt ничего не разрешает и не запрещает. Открыть или закрыть сайт для ИИ-ботов можно только правилами robots.txt. Посмотреть, что в них сейчас написано, поможет бесплатная проверка robots.txt.
От карты сайта формат отличается отбором. Sitemap честно перечисляет всё, что можно проиндексировать, а это тысячи адресов. Автор объясняет, почему карта не заменяет llms.txt: в ней обычно нет markdown-версий страниц, нет внешних ресурсов, и целиком она не влезет в контекстное окно модели. llms.txt — выбор редактора: десять-пятьдесят страниц, без которых сайт не понять.
Что такое llms-full.txt и markdown-версии страниц
llms-full.txt — один большой файл, в который склеено содержимое всех страниц документации в Markdown. Агенту не нужно ходить по ссылкам: всю справку он забирает одним запросом.
На llmstxt.org этот вариант не описан. Его популяризировала платформа документации Mintlify: 20 ноября 2024 года она объявила, что автоматически генерирует и /llms.txt, и llms-full.txt для документации своих клиентов, и подала второй как единый пакет, который удобно целиком загрузить в ИИ-помощника для программирования (блог Mintlify). С тех пор такая пара стала типичной для порталов документации.
Обычному сайту услуг или интернет-магазину полная версия чаще всего ни к чему. Склеивать каталог из тысячи карточек бессмысленно, а для сайта из двадцати страниц хватит обычного оглавления. Где llms-full.txt оправдан: справка к программному продукту, API-документация, база знаний, которую разработчики целиком подгружают в IDE.
Markdown-версии страниц — третья часть идеи. Предлагается отдавать чистый Markdown по тому же адресу с добавкой .md: например, /docs/page.html.md рядом с /docs/page.html. Тогда ссылки в оглавлении ведут не на тяжёлый HTML, а на чистый текст. Генераторы справки делают это сами; на обычной CMS это заметная доработка, и без неё всё работает.
Кто на самом деле читает llms.txt
Здесь российские гайды расходятся сильнее всего. Одни обещают, что файл «поможет попасть в ответы ChatGPT и Алисы», другие называют его бесполезным. Я собрал то, что подтверждается официальными источниками на октябрь 2026 года.
Google: поиск файл не использует
У Google позиция есть, и она однозначная. В руководстве Search Central по генеративному поиску (обновлено 10 июля 2026 года) llms.txt стоит первым пунктом в списке того, что можно не делать. Суть: для появления в Google Поиске, включая его генеративные функции, не нужно создавать новые машиночитаемые или ИИ-файлы и Markdown, потому что сам поиск их не использует.
Против формата Google при этом ничего не имеет. Там же оговорено: робот может найти и проиндексировать много типов файлов, но это не значит, что они обрабатываются особым образом. А в Lighthouse, инструменте Google для аудита страниц, есть отдельная проверка llms.txt. Если сервер отвечает на запрос ошибкой, страница получает замечание. Если файла нет и сервер возвращает 404, проверка помечается как неприменимая: по формулировке Google, файл «пока необязателен» (Chrome for Developers, май 2026).
Вывод: Lighthouse следит, чтобы llms.txt не ломал сервер, но на ранжирование в Google он не влияет.
Яндекс: официальной позиции нет
Официальных заявлений Яндекса об использовании llms.txt я не нашёл — ни в справке Вебмастера, ни в блоге компании, ни в описании того, как устроены ответы с нейросетью в поиске. Значит, утверждать, что его читают Яндекс или Алиса, нельзя. Утверждать обратное — тоже: позиции просто нет. Если в статье или у подрядчика вы видите «Яндекс учитывает llms.txt», просите источник.
Для поиска Яндекса работает то же, что и раньше: страница должна быть открыта роботу, проиндексирована и полезна. Как это проверить и ускорить, я разбирал в материале про индексацию сайта.
С OpenAI и Anthropic похоже. Обе компании публикуют llms.txt для своей документации: developers.openai.com/llms.txt и docs.anthropic.com/llms.txt, их перечисляет llmstxt.org. Но официальных заявлений, что их роботы читают llms.txt на чужих сайтах при обучении или поиске, на октябрь 2026 года нет. Наличие llms.txt у компании говорит лишь о том, что она публикует его для своих пользователей, а не о том, что её модели учитывают ваш.
Где файл работает: ИИ-агенты, IDE и документация
Реальная поддержка llms.txt сегодня — не у поисковиков, а у инструментов, куда человек сам приносит адрес. На llmstxt.org прямо написано, что сильнее всего файлы используют в программной документации: агенты для программирования идут по нему к справочникам API и руководствам.
Как это выглядит. Разработчик в Claude Code, Cursor или другой IDE с ИИ-помощником пишет: «подключи библиотеку, вот документация» — и вставляет адрес. Агент открывает llms.txt, видит структуру, забирает нужную markdown-страницу и пишет код по актуальному описанию API, а не по памяти модели. Здесь llms.txt помогает по-настоящему: агент не тратит контекст на меню и баннеры и получает данные без мусора. Пользователь ChatGPT с поиском, который просит «разберись, чем занимается этот сервис», тоже может наткнуться на этот файл, если модель решит его открыть.
Поэтому у нас llms.txt связан с подключением через ИИ-агента: тем, кто подключает сайт через Claude Code или Cursor, полезно, чтобы агент сразу видел, где лежат инструкции по вебхуку и интеграциям.
Как создать файл llms.txt за 15 минут
Для сайта на 20–100 страниц оглавление собирается руками быстрее, чем настраивается генератор. Большим справочным порталам разумнее генерация.
Вручную: пять шагов
- Выберите страницы. Главная, ключевые услуги или категории каталога, цены, контакты, условия доставки и возврата, справка. Обычно выходит 10–40 ссылок. Весь sitemap не выгружайте.
- Напишите описание. Цитата под названием — одна-две фразы с фактами: что за компания, что делает, где работает. Без «лидер рынка» и «лучшие цены»: модель ищет данные, а не рекламу.
- Добавьте подробности. Абзац или перечень того, о чём чаще всего спрашивают: регион, способы оплаты, сроки, ограничения. Если данные о ценах меняются, ставьте дату.
- Разложите страницы по разделам H2. К каждой — короткое пояснение после двоеточия: что внутри и кому это нужно. Второстепенное — в Optional.
- Опубликуйте. Сохраните текстовый файл в UTF-8 под именем
llms.txtи положите в корень, чтобы он открывался по адресуhttps://ваш-сайт.ru/llms.txt. Убедитесь, что сервер отдаёт код 200 и типtext/plainилиtext/markdown.
Ссылки в файле должны быть рабочими и каноническими: без редиректов, без UTM-меток и прочих параметров. UTM в llms.txt только засоряет статистику и подсовывает агенту дубли одной страницы.
Генераторы и плагины CMS
Если писать руками не хочется, есть готовые решения. В разделе интеграций на llmstxt.org перечислены:
- Mintlify и GitBook — платформы документации, которые отдают llms.txt автоматически;
- Yoast SEO и AIOSEO — плагины WordPress со встроенным генератором;
- Wix — создаёт его для каждого сайта на платформе;
- Drupal — рецепт LLM Support для версий 10.3+;
- VitePress и Docusaurus — плагины для порталов документации.
На WordPress проще всего включить генерацию в SEO-плагине, если он уже стоит. Остальные базовые настройки этой платформы я собрал в чек-листе по SEO для WordPress. На 1С-Битрикс, Tilda и самописных сайтах оглавление обычно проще написать вручную и залить через FTP или файловый менеджер.
У автоматических генераторов есть ловушка: многие строят перечень из sitemap и вываливают сотни адресов без пояснений. Получается та же карта сайта, только в Markdown. Отбор и пояснения — главная ценность llms.txt, и их генератор за вас не сделает.
Как проверить, что llms.txt работает
Проверка идёт в три этапа, от простого к содержательному.
Доступность. Откройте адрес в браузере в режиме инкогнито: кириллица читается, редиректа на главную нет, код ответа 200. Lighthouse в Chrome покажет замечание, если сервер отвечает ошибкой.
Структура. Есть заголовок с названием, цитата с описанием, разделы H2 с перечнями, все адреса открываются. Битые ссылки — частая беда после переезда или смены структуры URL.
Смысл. Совет из спецификации: дайте агенту только ваш llms.txt и задайте вопросы о сайте. Например, загрузите его в ChatGPT и спросите «сколько стоит услуга», «работаете ли вы в моём городе», «как с вами связаться». Модель отвечает верно и показывает нужные страницы — оглавление составлено хорошо. Путается — дописывайте подробности и проверяйте, хватает ли в файле данных для ответа.
Чего проверить не получится: влияет ли файл на цитирование в ответах нейросетей. Обращения к адресу видно в логах сервера, но то, что робот запросил файл, ещё не значит, что его содержимое где-то использованы. Свой вариант я выложил в октябре 2026 года, и делать выводы о пользе пока рано.
Нужен ли llms.txt вашему сайту
Честный ответ: навредить он не может, а польза зависит от того, кто ваши читатели. Google прямо пишет, что эти файлы не помогают и не вредят видимости в поиске, а поддерживать их ради других систем — нормально.
Делать стоит, если:
- у вас документация, API или справка к программному продукту — разработчики будут подгружать её в IDE, и наличие llms.txt реально сэкономит им время;
- у вас SaaS или сложная услуга, о которой люди спрашивают ИИ-помощников, и вы хотите дать им точные данные о ценах и условиях;
- сайт большой и запутанный, и короткое оглавление поможет агенту найти нужное;
- у вас уже стоит плагин, который генерирует оглавление одной галочкой: остаётся 15 минут на проверку.
Можно отложить, если:
- у вас визитка на пять страниц — агент разберётся и по HTML;
- на сайте есть проблемы с индексацией, скоростью или контентом — сначала решите их;
- вы рассчитываете, что файл поднимет позиции или трафик из поиска, — этого не будет.
Я сделал llms.txt для ai-seowriter.ru, потому что продукт сложный: генерация, публикация в WordPress, 1С-Битрикс, InSales, Joomla и через вебхук, анонсы во ВКонтакте и Telegram, тарифы. ИИ-помощнику проще прочитать одну страницу с фактами, чем собирать их с тридцати. Но роста трафика от этого я не жду и никому не обещаю. Если хотите, чтобы сайт рос за счёт контента, вкладываться нужно в статьи: план, структуру, регулярность. Этим занимается генератор SEO-статей: он собирает структуру по выдаче, пишет текст и публикует его на сайт. llms.txt — небольшое дополнение к такому сайту, а не замена.
Частые ошибки при внедрении llms.txt
- Весь sitemap внутри. Сотни адресов без пояснений превращают оглавление в свалку и не влезают в контекст модели.
- Рекламное описание. «Лидер рынка с безупречной репутацией» для модели — пустые слова. Нужны данные: что, где, сколько стоит.
- Ожидание запрета. llms.txt ничего не закрывает. Закрыть контент от ИИ-ботов можно только в robots.txt.
- Битые и устаревшие адреса. Оглавление создают один раз и забывают, а через полгода половина пунктов ведёт на 404. Назначьте человека, который обновляет его при изменении структуры.
- Служебные страницы. Не включайте закрытые разделы, черновики и админку: документ публичный.
- Кодировка и место. Документ в Windows-1251 или в папке
/files/вместо корня агент либо не найдёт, либо прочитает кракозябры. - Вера в чудо. Внедрение llms.txt не заменяет SEO. Это оглавление для ИИ-агентов, а не новый фактор ранжирования.
Поделиться
Автоматизируйте SEO-публикации с SEO Writer
ИИ пишет статьи, публикует в CMS, заполняет мета-теги — без вашего участия
Начать бесплатно →Читайте также
GEO оптимизация сайта: как попасть в ответы нейросетей
Что такое GEO-оптимизация, откуда нейросети берут ответы, как Алиса и Google AI Overviews выбирают источники и что сделать на сайте, чтобы его цитировали.
EEAT-факторы: что это и как показать экспертность
Разбираю EEAT-факторы: опыт, экспертиза, авторитетность, доверие. Что из этого проверяет поисковик, при чём тут YMYL и как показать экспертность в статье с ИИ.
Токены нейросети: что это и как считать расход
Токены нейросети: чем токен отличается от слова, почему русский текст дороже английского и как считать расход генерации.
Интеграции SEO Writer


