 Bogdan Kolomiets
Токены нейросети: что это и как считать расход
TL;DR
Токены нейросети: чем токен отличается от слова, почему русский текст дороже английского и как считать расход генерации.
SLUG: tokeny-neyroseti
Коротко: токен — это кусок текста длиной обычно в 2–4 знака, и языковая модель считает деньги и память именно в таких кусках, а не в словах. Русский текст режется мельче английского, поэтому одна и та же по смыслу статья на русском обходится дороже — я проверил это замером и ниже покажу цифры.
Меня зовут Богдан, я делаю AI SEO Writer — сервис, который генерирует SEO-статьи и публикует их в CMS. Расход токенов для меня не абстракция, а себестоимость каждой статьи, которую выдаёт пайплайн. Я не раз видел, как одна лишняя строчка в системном промпте умножается на тысячу генераций и превращается в заметную сумму. Поэтому объясню без академизма: что такое токены в нейросети, откуда берётся их количество, как считать токены и на чём реально экономить.
Что такое токены в нейросети простыми словами
Модель не работает ни с буквами, ни со словами: на вход она получает куски текста. Прежде чем начать предсказывать, текст превращается в токены, и каждому куску присваивается номер из словаря. Дальше нейросеть видит только последовательность номеров: букв внутри модели нет.
Разрезание неравномерное. Частые сочетания знаков словарь держит целиком, редкие рубит на мелкие части. Английское tokenization — это ровно два фрагмента, token и ization. Русское «токенизация» на той же кодировке распадается на четыре: т, ок, ен, изация. Дело не в сложности языка, а в том, каких текстов было больше в выборке, на которой собирали словарь.
Почему токен — это не слово и не буква
Три базовых утверждения, которые чаще всего путают:
- Токен ≠ слово. На короткое частое слово уходит один, на длинное редкое — четыре-пять. Служебное «в» и слово «продвижение» стоят по-разному.
- Токен ≠ знак. По оценке OpenAI, для английского текста это четыре знака и три четверти слова, то есть 100 токенов ≈ 75 слов. Для русского пропорция другая.
- Пробел — часть токена. Пробел перед словом обычно приклеивается к нему и меняет разбиение: «привет» и « привет» дают разные последовательности. Регистр тоже влияет: слово с заглавной буквы может дать другое количество токенов, чем то же слово строчными.
Главная практическая мысль растёт отсюда: количество токенов нельзя прикинуть, глядя на число слов. Его надо либо измерять, либо считать по коэффициенту для конкретного языка.
Как нейросеть превращает текст в токены
Токенизация — так называется это разрезание — работает отдельным компонентом, токенизатором. Он не нейросеть, а детерминированный алгоритм со словарём: один и тот же текст он всегда разрежет одинаково.
Токенизатор и алгоритм BPE
Большинство современных моделей используют BPE, byte pair encoding. Идея простая: алгоритм начинает с отдельных байтов и по очереди склеивает самые частые пары в новые единицы, пока словарь не наберёт нужный размер. В итоге в словаре оказываются и целые частые слова, и куски вроде «ение», и одиночные байты для всего остального.
У OpenAI такой словарь называется кодировкой, и их несколько; нам важны две. Кодировка cl100k_base работала в GPT-3.5 и GPT-4, o200k_base пришла с GPT-4o. Второй словарь вдвое больше, и кириллических кусков в него попало заметно больше — поэтому русский текст на новых моделях стал дешевле. Библиотека tiktoken, которой считают расход для моделей OpenAI, гарантирует обратимость: из последовательности токенов исходный текст восстанавливается без потерь.
Пробел, регистр и специальные токены
Кроме обычного текста в поток попадают служебные единицы. Специальные метки размечают начало и конец сообщения, роль автора (система, пользователь, модель), границы вызова внешней функции. В интерфейсе они не видны, но тарифицируются наравне с текстом: OpenAI прямо предупреждает, что в подсчёт входит форматирующая разметка ролей и границ. Поэтому локальный подсчёт всегда даёт чуть меньше, чем реальный счёт API.
Отдельные токены расходуются и на не-текст: изображение, PDF или аудио тоже проходят через токенизатор перед обработкой.
Почему русский текст расходует больше токенов, чем английский
Разберём, почему в русском тексте они кончаются быстрее. Причина в словаре: корпуса, на которых обучали токенизаторы, состоят преимущественно из английского, поэтому английские слова и морфемы попали в словарь целиком, а кириллица — обрывками.
Официального коэффициента ни OpenAI, ни Anthropic, ни Google не публиковали. Брать цифру из чужих блогов я не стал и замерил сам.
Замер на tiktoken: во сколько раз дороже русский абзац
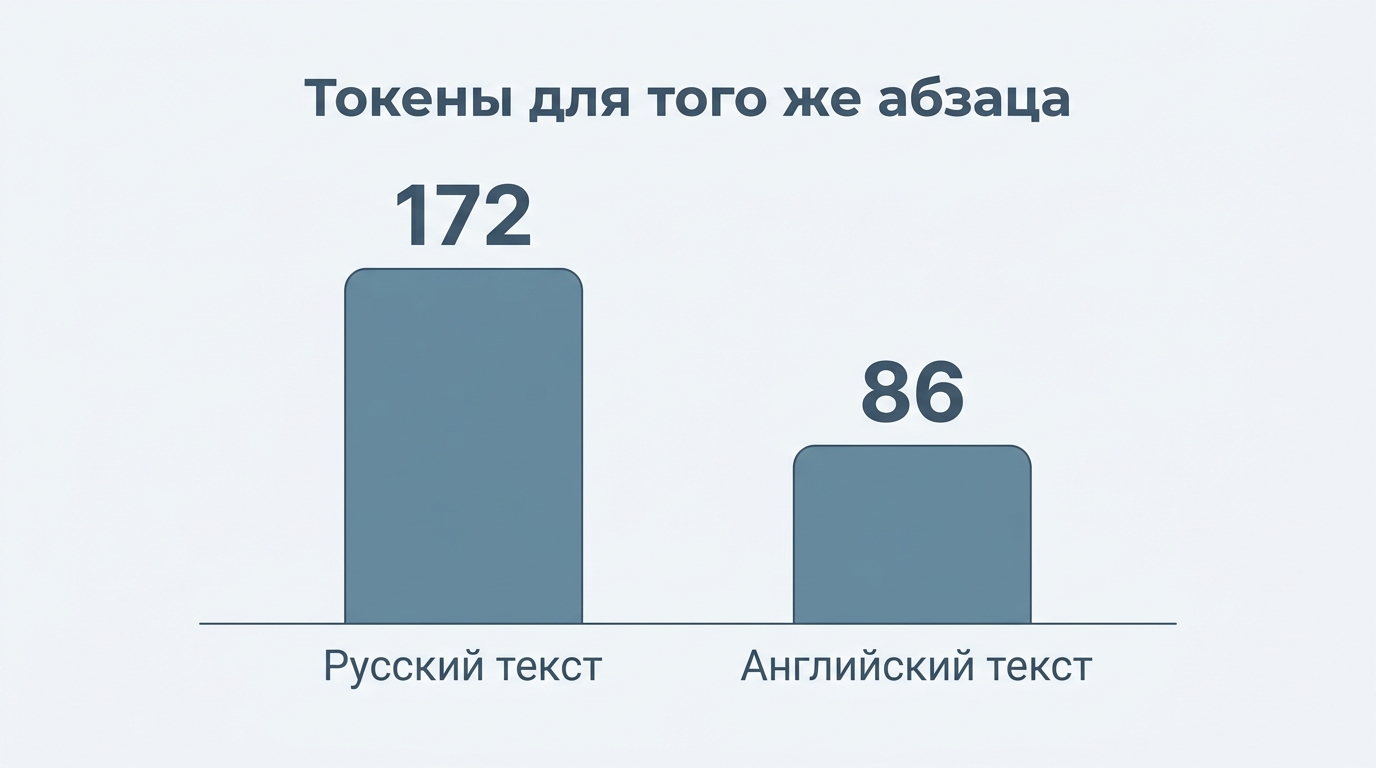
Я взял абзац из четырёх предложений на эту тему, перевёл его на английский с сохранением смысла и прогнал обе версии через tiktoken 0.13.0. Русская версия — 418 знаков и 70 слов, английская — 408 знаков и 78 слов.
| Кодировка | Русский | Английский | Во сколько раз дороже | Знаков на токен (рус.) |
|---|---|---|---|---|
| cl100k_base (GPT-3.5, GPT-4) | 172 | 86 токенов | 2,0 | 2,43 |
| o200k_base (GPT-4o и новее) | 111 | 86 | 1,29 | 3,77 |
На старой кодировке русский стоил ровно вдвое дороже английского. На новой разрыв сократился до 1,29 раза. Это самый наглядный результат замера: смена поколения токенизатора удешевила русскоязычную генерацию примерно в полтора раза, без единой правки в промптах.
Видно это и на отдельных словах. «Нейросеть» на cl100k_base — пять токенов: н, ей, рос, ет, ь. На o200k_base — три: ней, рос, еть. «Продвижение» было семь токенов, стало четыре. Английское neural в обеих кодировках — два.
Формула для прикидки в уме
Чтобы не гонять токенизатор каждый раз, я прогнал через него реальную статью блога на 4086 слов и 28 416 знаков. Вышло 12 222 токена на cl100k_base и 7903 на o200k_base.
Базовая прикидка для русского текста на современных моделях получается такая:
- 1000 знаков ≈ 280 токенов (на старых моделях — около 430).
- 1000 слов ≈ 1900 токенов (на старых — около 3000).
- Один знак ≈ 0,28 токена, то есть 3,6 знака против 4,74 у английского.
Для английского работает официальная оценка OpenAI: 100 токенов ≈ 75 слов, то есть 1000 слов ≈ 1330 токенов. Разница с русским — в полтора раза на новых моделях и вдвое на старых.
Входные и выходные токены: из чего складывается счёт
Токены влияют на счёт двумя статьями сразу, и цены у них разные.
Входные токены — всё, что уходит в модель: системное сообщение, ваш промпт, история диалога, приложенные файлы и служебная разметка. Их объём вы контролируете полностью.
Выходные токены — то, что модель сгенерировала. Токены ответа стоят в три-пять раз дороже входных. У GPT-4.1 это 2 доллара за миллион на входе и 8 долларов на выходе, у Claude Sonnet 5 — 2 и 10. Разница объясняется просто: обработка входа дешевле, чем порождение ответа по одному фрагменту за шаг.
Есть ещё две категории, о которых часто забывают:
- Кэшированные входные токены. Если повторяющаяся часть промпта уже отправлялась, она тарифицируется со скидкой. У GPT-4.1 кэшированный вход стоит 0,5 доллара против 2 — экономия до 75%.
- Токены рассуждений. У reasoning-моделей есть внутренние размышления, которые в ответе не показываются, но считаются как выходные. Счёт за такой запрос заметно больше видимого текста.
Контекстное окно: сколько текста нейросеть держит в памяти
Контекстное окно — это лимит на общее количество токенов в одном обращении: вход, выход и, у reasoning-моделей, токены рассуждений вместе. Всё, что не влезло, усекается — отсюда обрывающиеся на середине ответы и «забытое» начало длинного диалога.
Размеры сильно разошлись по вендорам. У Anthropic часть моделей работает с окном 200 тысяч токенов, у новых — до миллиона, при этом на сам ответ отводится до 128 тысяч. Google пишет, что многие модели Gemini идут с окном от миллиона токенов и больше. У OpenAI размер окна указан на странице конкретной модели и отличается от версии к версии — там его и стоит смотреть, а не полагаться на статьи двухлетней давности.
Переведу миллион токенов в понятное: по моему замеру это 520 тысяч слов русского текста, то есть три «Войны и мира» без сокращений. Но платить придётся за всё окно, которое вы заполнили.
Как считать расход и во что он обходится
Инструменты подсчёта токенов
Основные инструменты, которыми пользуюсь сам:
- Tokenizer от OpenAI — веб-страница, куда вставляют текст и сразу видят разбиение и количество токенов. Хорош, чтобы один раз посмотреть, как режется ваш типовой промпт.
- Библиотека tiktoken — то же самое в коде, вызовом encode для выбранной кодировки. Считает быстро, работает офлайн, подходит для массовых замеров.
- Ответ самого API. В поле usage приходит фактический расход по запросу: входные, выходные, кэшированные. Увидеть его можно, когда работаете по собственному API-ключу OpenAI. Это единственная цифра, за которую вы реально платите.
- Отдельный эндпоинт подсчёта. У OpenAI есть метод, который возвращает точное число входных токенов вместе со служебными; описание лежит в разделе docs на developers.openai.com. У Gemini ту же роль играет count_tokens.
Разница между локальным подсчётом и usage обычно небольшая, несколько процентов на служебной разметке. Но если вы строите бюджет на десятки тысяч запросов, эти проценты стоит закладывать.
Сколько токенов уходит на одну SEO-статью
Посчитаем на конкретном примере. Стандартная статья — 2000 слов на русском.
- Выход: 2000 слов × 1,9 — примерно 3800 токенов.
- Вход: структура, ТЗ, выдержки из выдачи, системное сообщение. Реалистично 6000–10 000 токенов, если модель ещё и разбирает конкурентов.
- По ценам GPT-4.1: 8000 входных — 1,6 цента, 3800 выходных — 3 цента. Итого около 5 центов за один вызов.
Важная поправка: полноценный пайплайн — это не один вызов. В генераторе SEO-статей у меня 19 шагов в стандартном режиме и 27 в лонгриде, и на каждом шаге модель что-то читает и что-то пишет. Реальная себестоимость статьи получается на порядок выше расчёта по одному запросу. Именно поэтому вопрос про расход токенов быстро превращается в вопрос, во сколько обойдётся контент-план на месяц.
Как экономить на токенах без потери качества
Пять способов, подтверждённых документацией вендоров, а не блогами:
- Включите кэширование промпта. Если у вас общий системный блок на все запросы, повторный вход тарифицируется со скидкой — у GPT-4.1 до 75%. Самая дешёвая оптимизация: менять ничего не надо, кроме порядка блоков в промпте.
- Ограничьте max_tokens. Выход дороже входа, поэтому потолок длины ответа режет счёт напрямую. Заодно спасает от ситуации, когда модель ушла писать эссе на ровном месте.
- Сократите системное сообщение. Оно уходит в каждый запрос. Лишние 300 токенов инструкций на тысяче генераций — это 300 тысяч токенов впустую.
- Управляйте историей диалога. История целиком идёт на вход. Резюмируйте старые сообщения или начинайте новый чат при смене темы, иначе вы платите за один и тот же контекст десятки раз.
- Берите модель под задачу. Разрыв между младшей и старшей моделью измеряется десятками раз: у GPT-4.1 nano вход стоит 10 центов за миллион против 2 долларов у полной версии. Базовые задачи вроде черновика и рубрикации спокойно тянет младшая, а переключаться между моделями разных вендоров удобно через один ключ OpenRouter.
Шестой приём держу как гипотезу, а не как правило: системные инструкции на английском обходятся вдвое дешевле на старых кодировках и примерно на треть — на новых. Основание — мой собственный замер выше, официальной рекомендации на этот счёт нет. Проверяйте на своей задаче: если качество ответа нейросети от смены языка инструкции падает, экономия не окупится.
Когда токены считать не нужно
Честно: для задач большинства владельцев сайтов вся эта арифметика не пригодится. Считать их имеет смысл в трёх случаях: вы работаете напрямую с API, у вас обрывается ответ на середине или вы упёрлись в лимит подписки. В чатах вроде ChatGPT или Яндекс Нейро расход за вас считает сам сервис.
Если вы просто пишете статьи, вопрос токенов становится вопросом тарифного плана. В AI SEO Writer системные ключи доступны на всех планах, включая бесплатный: расход считает сервис, а вы видите лимит в статьях, а не в токенах. Подключить свои API-ключи можно начиная со Starter — это разумно, когда у вас уже оплачен доступ к моделям и вы хотите гонять генерацию по своей цене.
Частые вопросы о токенах
1 токен — это сколько слов? Для английского — примерно 0,75 слова по официальной оценке OpenAI. Для русского на современных моделях — 0,5 слова: 1000 слов дают 1900 токенов.
Сколько токенов в 1000 знаков русского текста? По моему замеру — около 280 на кодировке o200k_base и около 430 на cl100k_base. Считайте по верхней границе, если не знаете, какая модель под капотом.
Токены в нейросетях и криптотокены — это одно и то же? Нет, совпадает только слово. В нейросетях токен — единица текста, к блокчейну отношения не имеет.
Почему токены заканчиваются быстрее, чем кажется? Потому что в счёт идёт не только ваш вопрос: туда попадают системное сообщение, вся история диалога, служебная разметка и невидимые вам размышления модели.
Как узнать точный расход по конкретному запросу? Смотреть поле usage в ответе API. Локальный токенизатор даёт оценку, usage — факт.
Что запомнить
Токены — это единицы, в которых нейросеть меряет и память, и деньги. Русский текст на актуальных моделях стоит в 1,29 раза дороже английского того же смысла, а на моделях прошлого поколения стоил вдвое дороже. Тысяча русских слов — это около 1900 токенов, тысяча знаков — около 280. Выход дороже входа в три-пять раз, а самый быстрый способ сократить счёт — кэширование промпта и потолок max_tokens.
И последнее. Если считать их вручную не хочется, это нормальная позиция: смысл сервиса генерации в том, чтобы вы думали о контент-плане, а не о кодировках.
Automate SEO publishing with SEO Writer
AI writes articles, publishes to CMS, fills meta tags — without your involvement
Start for free →Read also
Invalid API Key OpenAI: Fix the 401 Error
Getting a 401 invalid_api_key from OpenAI? Here is the fast checklist, the real causes, a curl test, and how 401 differs from 403 and 429.
OpenRouter Free Models: Limits and Trade-offs
What OpenRouter free models really give you: current rate limits, what your prompts pay for, how to pick one, and when to move to paid.
How to Get an OpenAI API Key (ChatGPT API)
Create an OpenAI API key step by step: project vs user keys, billing tiers, curl and Python calls, safe storage, and spend limits.
SEO Writer integrations


