 Bogdan Kolomiets
Индексация сайта: как проверить и ускорить попадание в поиск
TL;DR
Что такое индексация сайта, как проверить страницы в Яндекс Вебмастере и Search Console, почему они не индексируются и как ускорить попадание в индекс.
SLUG: indeksaciya-sayta
Коротко: пока страницы нет в поисковом индексе, её не существует для пользователя. Можно вылизать текст, собрать семантику и закупить ссылки — если робот страницу не забрал в базу, она не покажется ни по одному запросу.
Я Богдан, основатель сервиса AI SEO Writer. Мы публикуем статьи в CMS клиентов пачками, и первая же массовая выгрузка научила меня простой вещи: узкое место чаще не в тексте, а в том, что робот до страницы физически не доехал или доехал и отказался её брать. Разбор этих двух ситуаций и есть содержание статьи.
Дальше — что такое индексация сайта по шагам, три способа проверить, попала ли страница в базу Яндекса и Google, список технических причин, из-за которых страницы вылетают, и рабочие способы ускорить процесс: переобход, IndexNow, sitemap и перелинковка.
Что такое индексация сайта и как страница попадает в поисковый индекс
Индексация сайта — это добавление его страниц в базу данных поисковой системы. Поисковый индекс устроен как гигантский каталог: робот скачал веб-страницу, разобрал текст, картинки и разметку, определил язык и тему и записал всё это к себе. Когда пользователь вводит запрос, поисковик ищет ответ не в интернете, а в своём индексе.
Отсюда два следствия, о которых часто забывают.
Первое: индексирование и ранжирование — не одно и то же. Попадание в индекс означает лишь то, что страница допущена к участию в выдаче. Позицию определяют уже другие алгоритмы.
Второе: у Яндекса и Google независимые поисковые базы. Страница может спокойно жить в индексе Яндекса и одновременно отсутствовать в Google. Проверять и настраивать индексацию сайта в поисковых системах приходится отдельно в каждой панели.
И главное, что стоит принять сразу: гарантий нет. Документация Google Search Central прямо говорит, что попадание в индекс не гарантировано ни для одной страницы — поисковая система сама решает, индексировать документ или нет. Яндекс формулирует мягче, но в отчёте по исключённым страницам у него есть статус «Страница малоценная или маловостребованная», что означает ровно то же самое.
Откуда поисковая система вообще узнаёт, что у вас появился новый документ? Источников три: ссылки с других страниц вашего же сайта, файл sitemap.xml и внешние упоминания — ссылки с чужих ресурсов, RSS, соцсети. К этому добавляются прямые уведомления: переобход в панели вебмастера и протокол IndexNow. Всё, что дальше в статье про то, как ускорить индексацию сайта, сводится к работе с этими каналами обнаружения.
Сканирование и индексирование — разные этапы
Путь страницы в выдачу состоит из трёх шагов, и застрять она может на любом.
| Этап | Что происходит | Где видно |
|---|---|---|
| Сканирование (краулинг) | Робот запрашивает URL и получает код ответа и HTML | «Статистика обхода» в Вебмастере, логи сервера |
| Индексирование | Поисковик разбирает содержимое и решает, класть ли документ в базу | «Страницы в поиске», отчёт «Индексирование страниц» в Search Console |
| Выдача | Документ участвует в ранжировании по запросам | Позиции, клики, показы |
Эти этапы разделены во времени, и разница между ними видна в статусах панелей. В Google Search Console есть два соседних состояния, которые новички путают. «Обнаружена, не проиндексирована» значит, что Google узнал про URL, но ещё ни разу его не скачал — часто потому, что отложил обход из-за нагрузки на сервер. «Просканирована, но пока не проиндексирована» — робот страницу уже взял и решил не класть в базу; официальная справка отдельно предупреждает, что повторно отправлять такой URL на обход бессмысленно, пока не устранена причина.
Разные статусы требуют разных действий. В первом случае разбираются с обнаружением и скоростью сервера, во втором — с содержимым страницы.
Как проверить индексацию страниц сайта
Проверить индексацию можно тремя способами, и они отвечают на разные вопросы.
| Инструмент | На какой вопрос отвечает | Точность |
|---|---|---|
| Оператор site: | Есть ли конкретный URL в выдаче прямо сейчас | Низкая для количества, высокая для факта |
| Яндекс Вебмастер | Сколько страниц в поиске у Яндекса и почему остальные исключены | Высокая |
| Google Search Console | Что поисковик думает про конкретный URL и целый сайт | Высокая |
Панели вебмастеров дают статусы и причины, поисковая строка — только моментальный снимок. Начинать разбор проблемы стоит с панелей.
Оператор site: — прикидка, а не точная цифра
Запрос site:example.com в поисковой строке показывает документы одного домена. Формат работает и точечно: site:example.com/blog/kak-uskorit-indeksaciyu покажет одну конкретную страницу, если она в индексе.
А вот числу результатов над выдачей верить нельзя. Блог Google Search Central объяснял ещё в 2006 году, что расхождения в счётчике site: — особенность самого оператора, а не индекса. Мэтт Каттс отдельно уточнял, что Google округляет оценку до трёх значащих цифр: «около 138 000 000» — это именно оценка, а не подсчёт документов. Яндекс ведёт себя похоже, а заодно подмешивает в выдачу по оператору поддомены.
Практический вывод: подставить полный URL и увидеть его в выдаче — нормальный способ проверки конкретной страницы. Считать по этому оператору, сколько страниц сайта в индексе, и строить на этой цифре отчёт — нет.
Яндекс Вебмастер: отчёт «Страницы в поиске»
Раздел «Индексирование» → «Страницы в поиске» — главный источник правды по Яндексу. Он показывает две кривые: сколько страниц участвует в поиске и сколько исключено. Список исключённых выгружается с датой последнего визита робота, URL и статусом — Яндекс отдаёт до 50 000 URL.
Статусы исключения и стоит читать в первую очередь:
- META_NO_INDEX — страница закрыта метатегом robots с директивой noindex. Убрать запрет и отправить на переобход.
- DUPLICATE — документ признан дублем другого. Настроить 301 или canonical.
- NOT_CANONICAL — страница отдана в поиск под другим URL, указанным в canonical. Проверить, туда ли ведёт указатель.
- CLEAN_PARAMS — исключение по директиве Clean-param в robots.txt.
- Ошибка при загрузке или обработке — робот получил 3xx, 4xx или 5xx.
- Малоценная или маловостребованная — алгоритм не увидел спроса и пользы.
Рядом живёт отчёт «Статистика обхода»: количество страниц в день и среднее время ответа сервера. Это фактический бюджет обхода вашего сайта — сколько документов робот успевает забрать и насколько быстро вы ему отвечаете.
Google Search Console: проверка URL и отчёт об индексировании
Инструмент «Проверка URL» показывает по одному URL: проиндексирован ли он, какой canonical выбран, когда был последний обход. Кнопка «Проверить страницу на сайте» запускает живой запрос и показывает отрендеренный HTML — то, что робот реально видит. Кнопка «Запросить индексирование» ставит URL в очередь.
Суточный лимит на запросы индексирования Google официально не раскрывает: в справке сказано только, что лимит есть и при исчерпании появляется предложение вернуться завтра. По наблюдениям вебмастеров речь идёт про десяток URL в сутки на ресурс. Для массовых задач есть URL Inspection API с документированными лимитами: 2000 запросов в день на ресурс и 600 в минуту.
Общую картину даёт отчёт «Индексирование страниц» с понятными статусами: «Заблокировано в файле robots.txt», «Исключено тегом noindex», «Страница-дубликат без канонического варианта, выбранного пользователем», «Ошибка сервера (5xx)». Справка Google подчёркивает, что часть строк в отчёте — норма: служебные и намеренно закрытые страницы индексироваться и не должны. 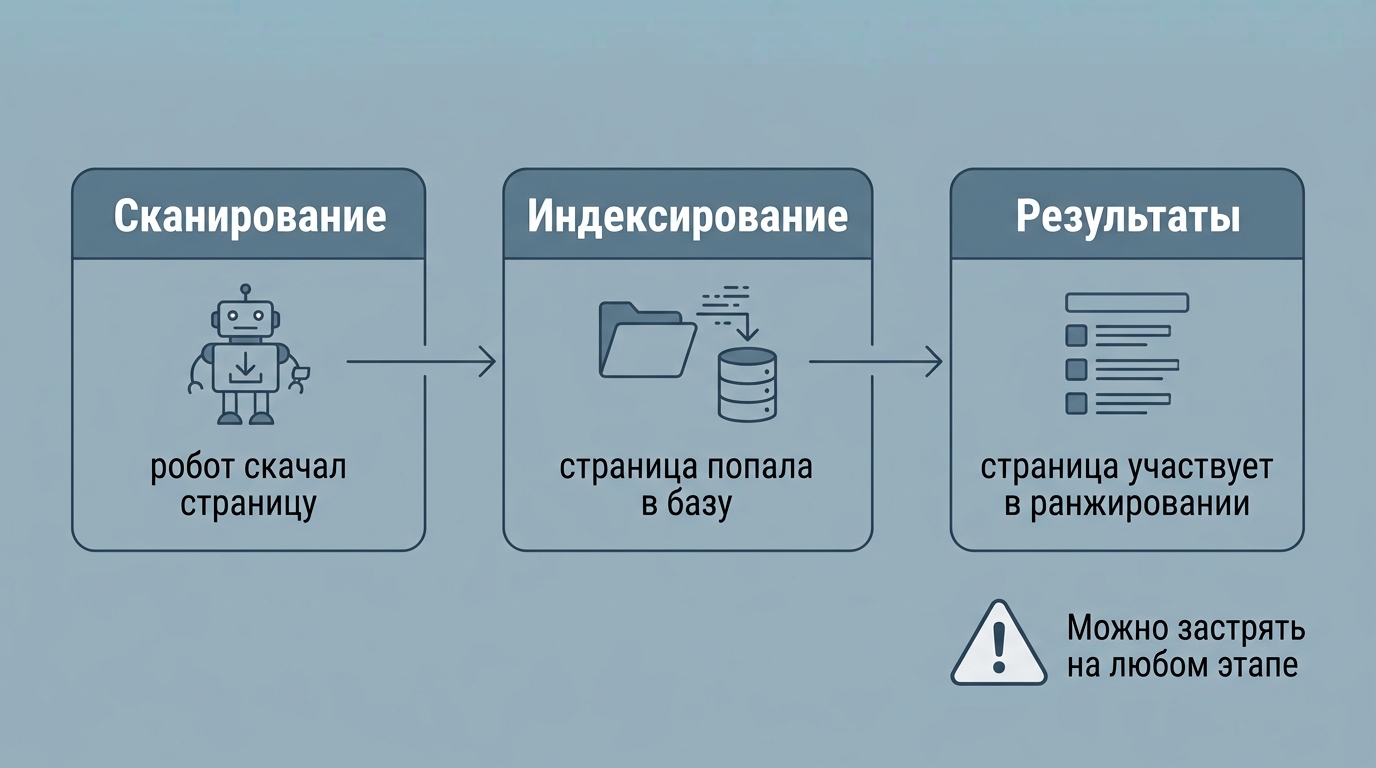
Почему страницы не индексируются
Все причины делятся на две группы. Технические отвечают на вопрос «может ли робот забрать страницу», содержательные — «хочет ли он её брать».
Разбирать надо в этом порядке. Пока страница отдаёт 500 или закрыта в robots.txt, обсуждать качество текста бессмысленно. И наоборот: если техника чистая, а Яндекс пишет «малоценная», второй запрос на переобход ничего не изменит — придётся дорабатывать саму страницу.
Содержательная группа причин на практике сводится к тонкому контенту: карточки товаров с одним предложением описания, страницы фильтров, отличающиеся друг от друга парой слов, заметки на 400 знаков без внятной структуры статьи. Поисковик видит документ, который дублирует десятки соседних и не отвечает ни на один запрос целиком, и отказывается тратить на него место. Лечится это не настройками, а тем, как написан сам SEO-текст: раскрытая тема, свои данные, отличающиеся заголовки и метаданные.
Ниже — три группы технических причин, с которых стоит начинать разбор.
Запреты: robots.txt, noindex и X-Robots-Tag
Три механизма запрета работают по-разному, и путаница между ними даёт самые обидные потери.
Директива Disallow в robots.txt запрещает роботу сканировать URL. Поисковик при этом может оставить документ в выдаче, если на него ведут ссылки — в отчёте появится строка «Проиндексировано, несмотря на блокировку в файле robots.txt». Яндекс отдаёт таким страницам статус «Запрет в robots.txt».
Метатег <meta name="robots" content="noindex"> и HTTP-заголовок X-Robots-Tag: noindex запрещают именно индексирование. Заголовок удобен для файлов, у которых нет HTML: PDF, изображения, выгрузки.
Классическая ошибка выглядит так: страницу закрыли в robots.txt и одновременно повесили на неё noindex. Робот не может скачать документ, значит, не видит метатег, значит, запрет на индексирование до него не доходит. Чтобы noindex сработал, страница должна быть доступна для сканирования.
Проверять запреты удобно в панелях: в Яндекс Вебмастере есть «Проверка ответа сервера», в Search Console — живая проверка URL, которая показывает и код ответа, и итоговый HTML.
Дубли и неправильный canonical
Дубли — самая частая причина, по которой число проиндексированных документов не сходится с реальным размером сайта.
Типовые источники дублей: доступность сайта одновременно по www и без www, по http и https, варианты со слэшем и без, UTM-метки и другие параметры, страницы фильтров и сортировок, пагинация, версии для печати.
Поисковые системы решают проблему сами, но не так, как хотелось бы владельцу: они выбирают один документ каноническим, а остальные исключают. В Google это статусы «Страница-дубликат без канонического варианта, выбранного пользователем» и «Страница является копией. Канонический вариант выбран Google». В Яндексе — DUPLICATE и NOT_CANONICAL.
Что делать:
- Настроить 301-редирект на основное зеркало — одно написание домена, один протокол, один вариант слэша.
- Прописать
rel="canonical"с абсолютным URL на самой странице и проверить, что он ведёт на нужный URL, а не на главную. - Для параметров в адресах использовать Clean-param в robots.txt — Яндекс склеит дубли и не будет тратить обход на мусор.
- Развести шаблонные Title и description: одинаковые метаданные у сотни карточек — дополнительный сигнал дубля.
Ошибки сервера, медленный ответ и JavaScript
Важные страницы обязаны отдавать 200 OK. Справка Яндекса указывает коды 3xx, 4xx и 5xx как причину исключения, у Google для этого есть отдельный статус «Ошибка сервера (5xx)». Разовый сбой не страшен, устойчивые пятисотки выбивают документы из базы.
Скорость ответа влияет не на факт индексации, а на её объём. Документация Google по краулинговому бюджету описывает это как crawl capacity limit: если сайт стабильно отвечает быстро, лимит растёт, если медленно или с ошибками — Google обходит меньше адресов. В Яндексе тот же механизм виден в «Статистике обхода» через среднее время ответа; практики считают комфортным ориентиром время до 300 мс и говорят о заметном замедлении обхода после 600 мс.
Сам краулинговый бюджет стоит держать в голове далеко не всем. Рекомендации написаны для сайтов от миллиона страниц с недельным обновлением и для проектов от 10 000 страниц с ежедневным. Про небольшие проекты в справке сказано отдельно: ресурсы в несколько тысяч URL обходятся эффективно и без специальной оптимизации. Если у вас блог на 200 статей и они не индексируются, дело не в бюджете.
Отдельная история — контент, который появляется только после выполнения JavaScript. Поисковик индексирует отрендеренный HTML, но рендеринг стоит ресурсов и происходит не мгновенно. Если основной текст подгружается скриптом и в исходном коде его нет, шанс получить «Просканирована, но пока не проиндексирована» резко растёт. Проверить просто: откройте живую проверку URL в Search Console и посмотрите, есть ли ваш текст в HTML, который получил робот.
Как ускорить индексацию сайта
Ускорить индексирование сайта — значит решить две задачи: помочь поисковой системе быстрее обнаружить документ и дать ему повод считать страницу нужной. Первая задача решается инструментами, вторая — содержанием. Ни один способ ниже не гарантирует попадания в индекс, все они влияют на скорость обнаружения.
| Способ | Для какой системы | Когда применять |
|---|---|---|
| Переобход страниц | Яндекс | Единичные важные URL, в пределах суточной квоты |
| IndexNow | Яндекс, Bing, Seznam, Naver | Каждая публикация и правка, до 10 000 адресов за раз |
| Запрос индексирования | Единичные URL, лимит не раскрыт | |
| Sitemap.xml | Яндекс и Google | Всегда, как базовый канал обнаружения |
| Внутренние ссылки | Обе системы | Всегда, особенно для новых разделов |
Переобход страниц в Яндекс Вебмастере
Раздел «Индексирование» → «Переобход страниц» — прямой способ сказать роботу Яндекса, что документ изменился. Адреса добавляются по одному на строку.
Суточная квота индивидуальна для сайта и показана прямо в интерфейсе под полем ввода: у небольших проектов это десятки URL, у крупных — сотни. Через API Вебмастера квоту можно смотреть программно: метод /recrawl/quota возвращает daily_quota и остаток quota_remainder.
По срокам ориентиры такие: робот приходит на отправленные URL вне очереди в течение трёх дней, а обновление данных в поисковой базе после обработки заявки занимает до двух недель. Инструмент хорош для единичных важных страниц — новой посадочной, переписанной статьи, исправленной карточки. Гнать через него весь сайт бессмысленно: квота кончится, а решение об индексации всё равно примет алгоритм.
IndexNow: уведомление поисковых систем за секунды
IndexNow — открытый протокол, которым сайт сам сообщает поисковикам, что URL появился, изменился или удалён. Вместо ожидания робота вы отправляете ему один HTTP-запрос.
Что важно знать перед внедрением:
- Протокол поддерживают Яндекс, Bing, Seznam, Naver и ещё несколько систем. Google IndexNow не поддерживает — он тестировал протокол в 2021 году, но так и не внедрил, поэтому для Google остаются sitemap и Search Console.
- Для подтверждения владения сайтом в корень кладётся текстовый файл
{ключ}.txtв кодировке UTF-8, внутри — только сам ключ, без пробелов и переносов. Имя файла должно совпадать со значением параметраkey. - Одним POST-запросом отправляется до 10 000 адресов. При превышении сервер вернёт ошибку 422.
- Простейший вариант для одной страницы — GET-запрос вида
https://<поисковик>/indexnow?url={адрес}&key={ключ}.
Практически это выглядит так. Ключ генерируется один раз — любая случайная строка из букв и цифр. Файл с этим ключом кладётся в корень сайта и открывается по прямому адресу. Дальше на каждую публикацию или правку отправляется запрос со списком изменённых адресов, и поисковик ставит их в очередь обхода.
Это тот случай, когда автоматизация окупается сразу. У меня в сервисе пинг уходит сам: как только статья опубликована в CMS, уведомление улетает в IndexNow, и мне не нужно помнить про ручной переобход по каждому материалу. Ручной сценарий тоже рабочий, просто на десяти статьях в неделю про него забываешь на второй неделе — а при публикации по расписанию отправлять уведомление руками некому в принципе.
Честная оговорка: IndexNow ускоряет обнаружение документа, а не гарантирует его попадание в индекс. Если страница слабая, робот приедет быстрее и быстрее откажется.
Sitemap.xml, перелинковка и регулярность публикаций
Три базовые вещи, без которых остальные способы работают вполсилы.
Sitemap.xml. Карта сайта — список URL, которые вы считаете достойными обхода. Лимиты одинаковы у Google и Яндекса: до 50 000 URL и до 50 МБ в несжатом виде на файл, кодировка UTF-8. Больше — разбивайте на несколько файлов и собирайте sitemap index. Из необязательных тегов смысл имеет только lastmod, и то при условии, что дата честная: Google открыто пишет, что игнорирует priority и changefreq, а lastmod учитывает, только если ему можно верить. Проставлять всем страницам сегодняшнюю дату — способ научить поисковик не доверять вашей карте.
Внутренние ссылки. Страница без входящих ссылок — сирота: робот про неё узнаёт только из карты сайта, и приоритет у неё низкий. Каждая новая статья должна получать ссылки из старых материалов и из разделов, а не висеть в одиночестве. Заодно перелинковка передаёт вес и удерживает читателя.
Регулярность. Поисковые системы подстраивают частоту визитов под темп обновления сайта. Ресурс, который публикует материалы по расписанию, робот обходит чаще, чем тот, что выкладывает десять статей раз в квартал. График здесь важнее объёма.
Как закрыть страницы от индексации и не сломать сайт
Управлять индексацией — это не только загонять документы в базу, но и убирать из неё мусор. Индексировать нужно не всё подряд. Чем меньше в базе бесполезных адресов, тем понятнее поисковику структура сайта.
Что закрывают почти всегда: корзину и оформление заказа, личный кабинет, страницы результатов внутреннего поиска, служебные и технические разделы, дубли с параметрами и метками, тестовые поддомены и версии для печати.
Как закрывать правильно:
| Задача | Инструмент |
|---|---|
| Убрать страницу из индекса | <meta name="robots" content="noindex"> на доступной для сканирования странице |
| Убрать из индекса файл без HTML | Заголовок X-Robots-Tag: noindex |
| Не тратить обход на параметры | Clean-param в robots.txt для Яндекса |
| Снять нагрузку от обхода мусорных разделов | Disallow в robots.txt |
| Закрыть тестовый стенд | Авторизация на уровне сервера, а не robots.txt |
Две ошибки, которые встречаются чаще всего. Первая уже описана выше: noindex на странице, закрытой в robots.txt, не работает. Вторая — закрытие тестового поддомена одним robots.txt: файл легко теряется при переносе на боевой сервер, и в индекс уезжает копия сайта. Стейджинг надёжнее закрывать паролем.
Сколько ждать индексации и когда бить тревогу
Точных сроков не обещает ни одна поисковая система. Google формулирует диапазон от нескольких часов до нескольких недель и напоминает, что часть страниц не индексируется никогда; Джон Мюллер в своих ответах называл ориентиром неделю для качественного контента на живом сайте. Новому домену нужно больше: первые страницы обычно заходят в индекс за две-четыре недели.
По Яндексу ориентиры считаются от инструментов: переобход отрабатывает в течение трёх дней, обновление в поисковой базе — до двух недель.
Отсюда рабочее правило. Для сайта, который уже получает трафик, две недели без индексации новой страницы — повод разбираться. Для нового домена спокойный горизонт — месяц.
Порядок проверки, когда время вышло:
- Страница отдаёт 200 OK — проверяю в «Проверке ответа сервера» Вебмастера.
- Адрес не закрыт в robots.txt и на нём нет noindex ни в метатеге, ни в заголовке.
- Canonical ведёт на сам этот URL, а не на другую страницу.
- Адрес есть в sitemap.xml, и карта отдаётся без ошибок.
- На страницу ведёт хотя бы пара внутренних ссылок.
- В «Страницах в поиске» и в отчёте Search Console смотрю статус: если написано «малоценная» или «просканирована, но не проиндексирована», проблема в содержимом, а не в технике.
Первые пять пунктов закрываются за полчаса. Шестой — самый неприятный, потому что требует переписывать страницу, а не крутить настройки. 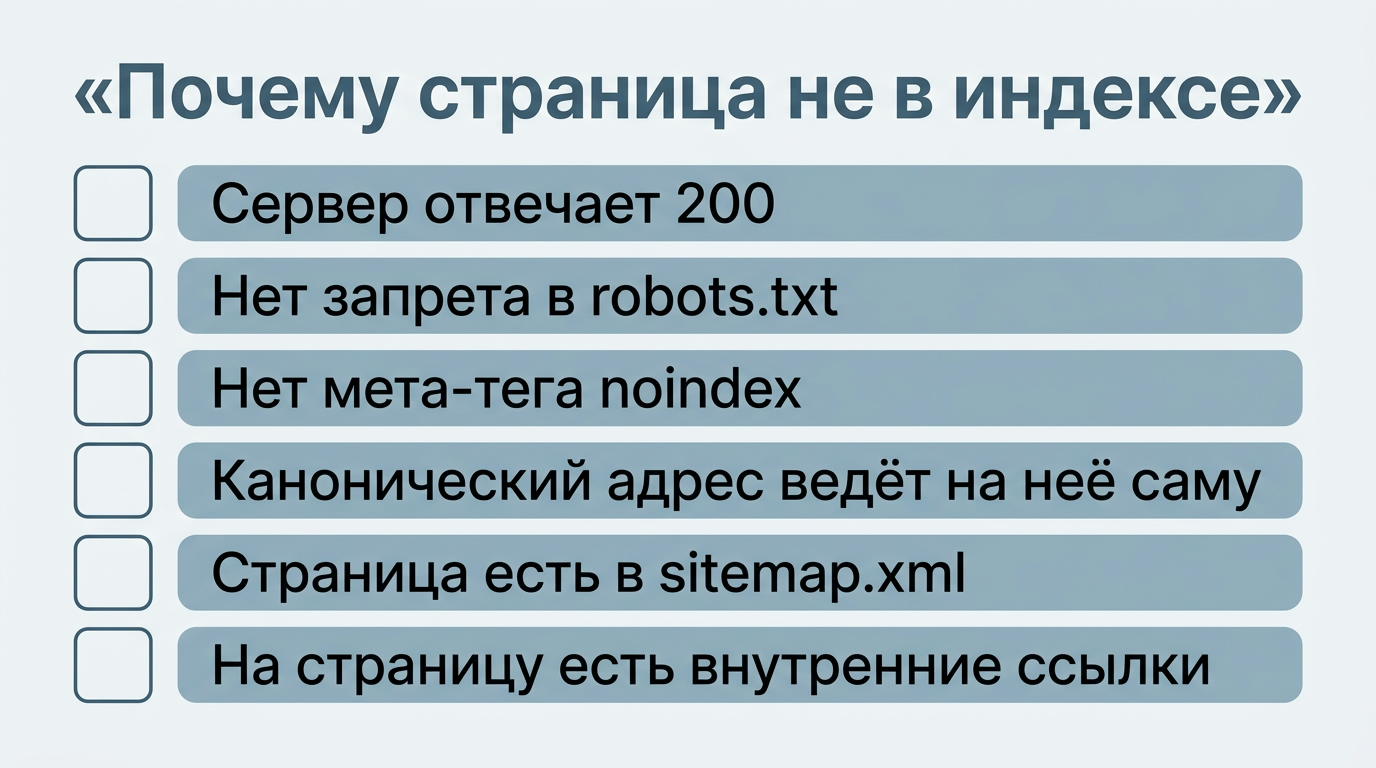
Частые вопросы про индексацию сайта
Сколько страниц моего сайта в индексе? Смотрите «Страницы в поиске» в Яндекс Вебмастере и отчёт «Индексирование страниц» в Search Console. Цифра из оператора site: — оценка, для отчёта она не годится.
Страница есть в Яндексе, но её нет в Google. Это нормально? Да, базы независимы. Прогоните её через «Проверку URL» в панели: обычно причина в статусе «Обнаружена, не проиндексирована» или в canonical, который указывает на другую страницу.
Нужен ли sitemap.xml маленькому сайту? Полезен даже для десяти страниц: карта помогает поисковой системе узнать обо всех страницах сразу. Но она не лечит запреты и не заменяет внутренние ссылки.
Ускорит ли переиндексацию обновление старой статьи? Робот приходит повторно, если видит смысл. Дописать абзац ради даты — слабый повод; переработать структуру, добавить данные и обновить lastmod честной датой — рабочий.
Влияет ли скорость сайта на индексацию? На попадание в индекс — нет, на его объём — да. Медленный ответ сервера снижает число документов, которые робот успевает обойти за визит. Для сайта на 50 страниц это незаметно, для каталога на 50 000 — критично.
Страница выпала из индекса. Что делать? Сначала посмотрите статус в панели: исключения по noindex, robots.txt и ошибкам сервера чинятся за час. Если стоит «малоценная или маловостребованная», технические правки не помогут — нужна доработка содержимого и отправка на переобход после неё.
Automate SEO publishing with SEO Writer
AI writes articles, publishes to CMS, fills meta tags — without your involvement
Start for free →Read also
Invalid API Key OpenAI: Fix the 401 Error
Getting a 401 invalid_api_key from OpenAI? Here is the fast checklist, the real causes, a curl test, and how 401 differs from 403 and 429.
OpenRouter Free Models: Limits and Trade-offs
What OpenRouter free models really give you: current rate limits, what your prompts pay for, how to pick one, and when to move to paid.
How to Get an OpenAI API Key (ChatGPT API)
Create an OpenAI API key step by step: project vs user keys, billing tiers, curl and Python calls, safe storage, and spend limits.
SEO Writer integrations


