 Bogdan Kolomiets
Проверить текст на уникальность: сервисы и нормы
TL;DR
Как проверить текст на уникальность: почему сервисы дают разный процент, какие нормы приняты и когда низкий показатель не страшен.
Коротко: вставить материал в форму антиплагиата — дело тридцати секунд, а понять цифру в отчёте о проверке сложнее. Один и тот же абзац даёт 97 процентов в одном сервисе и 78 в другом, и оба показания честные: считают они разное.
«Я прогоняю через антиплагиат каждый материал блога и давно перестал ориентироваться на одну цифру: проверка уникальности говорит только о совпадениях с чужими страницами и ничего — о пользе написанного», — Богдан, автор блога AI SEO Writer.
Сразу о своей позиции: мы делаем сервис генерации статей нейросетью, то есть в этой теме я сторона заинтересованная. Поэтому обещаний «стопроцентной уникальности» дальше не будет.
Что показывает проверка уникальности, а что нет
Метрика отвечает ровно на один вопрос: сколько кусков вашего материала уже встречается в базе сервиса. Это не оценка качества, не сверка фактов и не признак того, что написанное кому-то нужно.
Проверить текст на плагиат и оценить его пользу — две разные задачи, и сервис решает только первую.
Отсюда два следствия. Первое: полная оригинальность бывает и у бессмысленного набора слов. Второе: результат проверки в 80 процентов у грамотного обзора часто означает, что автор честно процитировал норму закона и назвал вещи общепринятыми терминами.
Похожие оговорки касаются соседних показателей отчёта — водности и заспамленности: они про форму подачи, а не про смысл текста.
Как устроены сервисы: шинглы, леммы и поиск перефразирования
Механика проверки почти у всех одна. Сначала текст нормализуют: снимают пунктуацию и HTML-теги, ослабляют вес служебных слов, часть систем приводит слова к начальной форме. Затем материал режут на шинглы — цепочки из нескольких подряд идущих слов, обычно от трёх до десяти. Каждый шингл хэшируют и ищут совпадения в базе.
Такой анализ текста отлично ловит прямой копипаст: если скопировать текст целиком, совпадут почти все цепочки. С перефразированием сложнее — одних шинглов мало, нужны лемматизация, снижение веса служебных слов, сравнение по векторам терминов. Дальше всех ушёл Антиплагиат.ру: он проверяет текст глубже, опираясь на морфологию и семантику, и находит заимствование там, где простая онлайн-проверка рапортует о чистоте.
Почему один и тот же материал даёт разный процент
Проверка уникальности текста в трёх сервисах даст три разных числа. Причин четыре, и все технические.
- Длина и шаг шингла. Короткая цепочка из двух-трёх слов цепляется за любые общие обороты, длинная из семи-десяти пропускает аккуратный рерайт. От длины текста это не зависит.
- Обработка морфологии. Одни системы сравнивают словоформы, другие — начальные формы.
- База сравнения. Онлайн-сервисы индексируют веб-страницы и собственные архивы, Антиплагиат добавляет коллекции вузов и диссертаций. Нет источника в базе — не будет и совпадения при проверке.
- Формула пересчёта. Где-то это сто минус доля совпавших цепочек, где-то с поправкой на длину заимствованных фрагментов и штрафом за сплошной копипаст.
Одна и та же проверка, запущенная дважды с интервалом в месяц, тоже способна дать разные числа: базы пополняются, а ваш материал мог попасть в индекс. Поэтому цифра без названия сервиса не значит ничего: 90 процентов по text.ru и 90 по Advego — разные измерения. 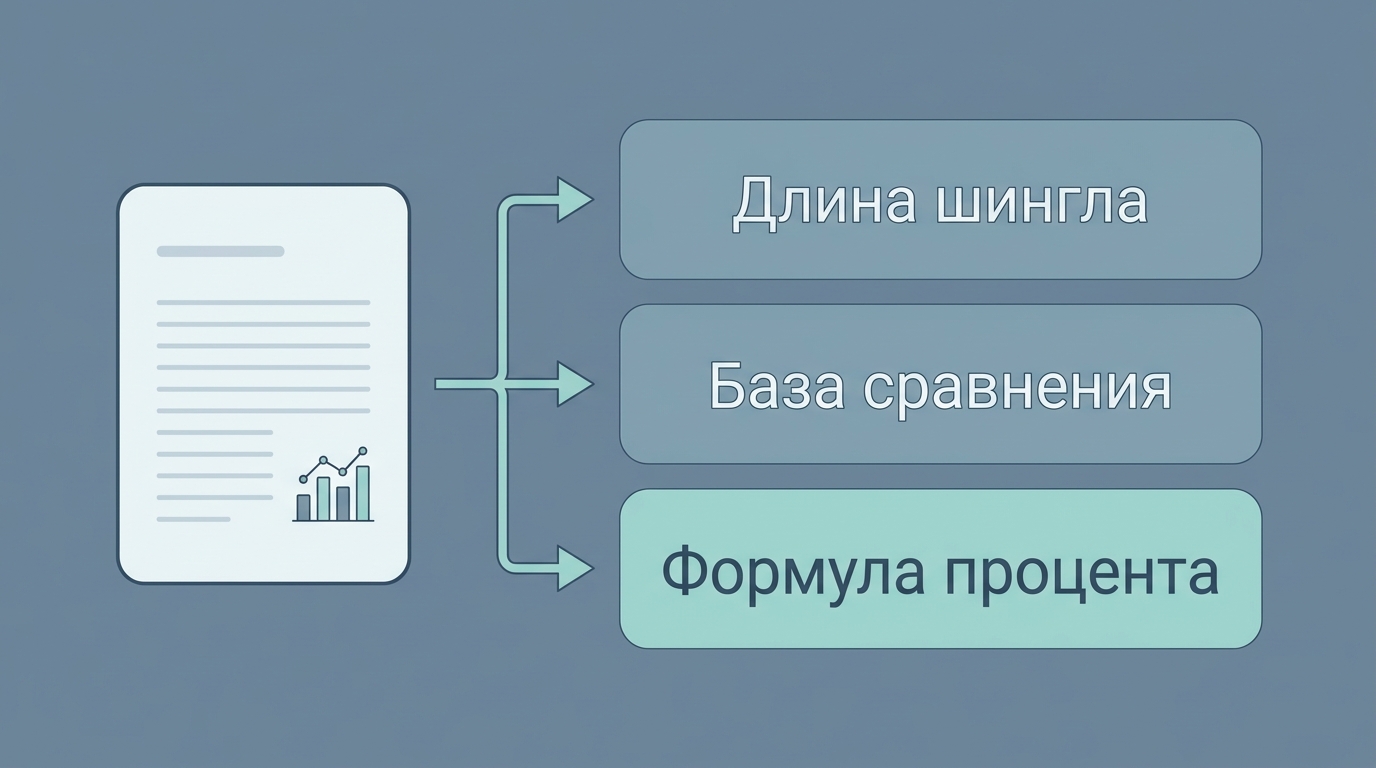
Чем различаются популярные сервисы проверки
| Сервис | Что считает помимо совпадений | На что смотреть |
|---|---|---|
| text.ru | водность, заспамленность, проверка орфографии | своя шкала воды, к ней привязаны ТЗ бирж |
| Content Watch | подсветку совпавших кусков и ссылки на источники | ориентирован на веб-страницы |
| Advego | классическую и академическую тошноту | в десктопном Плагиатусе видны длина и шаг шингла |
| eTXT | — | база включает материалы биржи, ловит перепродажи |
| Антиплагиат.ру | долю цитирования и заимствований | коллекции вузов, упор на перефразирование |
Content Watch показывает источники совпадений прямо в отчёте, а text.ru рядом с процентом сразу выдаёт водность и заспамленность. Остальные различия всплывают в мелочах: лимит символов на бесплатной проверке, загрузка документом, а не только вставкой в поле, разбор больших текстов без разбивки на части, набор языков. Если у вас документ на 200 тысяч символов, половина сервисов отпадёт сразу.
Какие нормы уникальности реально приняты
Единого требования нет ни в законе, ни в справках Яндекса и Google. Есть два разных мира.
Учебные работы. Порог задаёт вуз или кафедра — положением о выпускной работе или методичкой. По обзорам вузовских требований курсовая проходит при 60–75 процентах оригинальности, диплом бакалавра — при 65–75, магистерская — при 75–85. Цифры ориентировочные: свой порог смотрите в документе своего вуза, а не в интернете. Проверка на плагиат в вузе и та же процедура для веб-статьи различаются прежде всего базой сравнения.
Веб-контент. Здесь планку ставит заказчик. В ТЗ бирж встречаются 90–95 процентов с привязкой к инструменту: «не ниже 95 по text.ru». Это условие договора, а не требование поисковых систем.
У Яндекса и Google логика другая. Google в справке о полезном контенте пишет: материал, созданный ради трафика, а не для людей, приоритета не получит, а спам-политики марта 2024 года отдельно называют копирование чужого без существенной добавленной ценности. Отдельного штрафа за дубли у Google нет: дублирующиеся страницы кластеризуются, и в выдачу попадает каноническая версия. Яндекс числовых порогов тоже не публикует, а «Баден-Баден» бьёт по переоптимизированным текстам, написанным для роботов.
Водность и тошнота: что смотреть вместе с уникальностью
В отчёте о проверке обычно лежат ещё два показателя.
Водность — доля служебных и малозначимых слов. По шкале text.ru до 15 процентов считается минимальной водностью, 15–30 — нормальной, выше 30 — перебором. У Адвего своя методика и своя шкала, поэтому числа двух сервисов между собой не сравнивают.
Тошнота — про повторы. Классическая равна квадратному корню из числа вхождений самого частого слова: встретилось 16 раз — получаем 4. Академическая считает плотность всех значимых повторов в процентах; по описаниям Адвего нормальным считается диапазон 5–15. Норма зависит от объёма текста: значение, безобидное для лонгрида, для заметки в тысячу знаков уже перебор.
Проверка орфографии в тех же сервисах — приятный бонус, но корректора не заменяет: орфография ловится выборочно, а согласование и пунктуация проходят мимо. Обе метрики — часть требований к SEO-тексту, а не самостоятельная цель.
Когда низкая оригинальность — не повод переписывать
Совпадения бывают неизбежными и законными:
- цитаты и ссылки на нормативные акты — менять их нельзя;
- термины, названия стандартов, характеристики оборудования;
- юридические формулировки — оферта, политика обработки данных;
- типовые описания товаров из инструкции производителя.
Проверка честно подсветит эти куски как заимствование, и это нормально. Если такие фрагменты дали 20 процентов заимствований, ваш текст не стал хуже. Смотреть надо не на итоговое число, а на карту совпадений: какие фрагменты подсвечены и с чем они совпали.
Как повысить уникальность текста и не сломать смысл
Работающих приёмов немного, и все они про содержание. Синонимайзеры, латиница вместо кириллицы и невидимые символы дают материал, который человек читать не сможет, а поисковая система распознает как манипуляцию.
- Добавьте то, чего нет у конкурентов: собственные замеры, скриншоты своего интерфейса, расчёт на своих цифрах.
- Перестройте структуру, а не предложения: свой порядок разделов работает сильнее, чем перестановка слов внутри абзаца.
- Разбавьте общие места конкретикой — сроками, ценами, шагами.
- Проверьте спорные абзацы точечно: повторная проверка всего материала после каждой правки только съедает лимит.
Часть смежных задач закрывают бесплатные инструменты на нашем сайте — вроде генератора секретных ключей, который нужен при настройке публикации из сервиса в CMS.
Черновик текста с помощью нейросети собирается за минуты, но проверять фактуру, цифры и совпадения всё равно приходится руками: нейросеть ошибается предсказуемо, и эти места известны заранее. Высокий процент не спасает слабый материал, а низкий не всегда означает плагиат. Уникальность — гигиена, а не цель.
Уникальность — не единственное, что стоит посмотреть в готовом тексте. Анализ текста покажет воду, повторы и то, как в текст легли ключевые фразы — всё считается в браузере, текст никуда не отправляется.
Automate SEO publishing with SEO Writer
AI writes articles, publishes to CMS, fills meta tags — without your involvement
Start for free →Read also
Invalid API Key OpenAI: Fix the 401 Error
Getting a 401 invalid_api_key from OpenAI? Here is the fast checklist, the real causes, a curl test, and how 401 differs from 403 and 429.
OpenRouter Free Models: Limits and Trade-offs
What OpenRouter free models really give you: current rate limits, what your prompts pay for, how to pick one, and when to move to paid.
How to Get an OpenAI API Key (ChatGPT API)
Create an OpenAI API key step by step: project vs user keys, billing tiers, curl and Python calls, safe storage, and spend limits.
SEO Writer integrations


